Résumé de section
-
Ces documents contiennent les mêmes métriques, l’un sous forme de tableau csv, l’autre sous forme de graphiques.
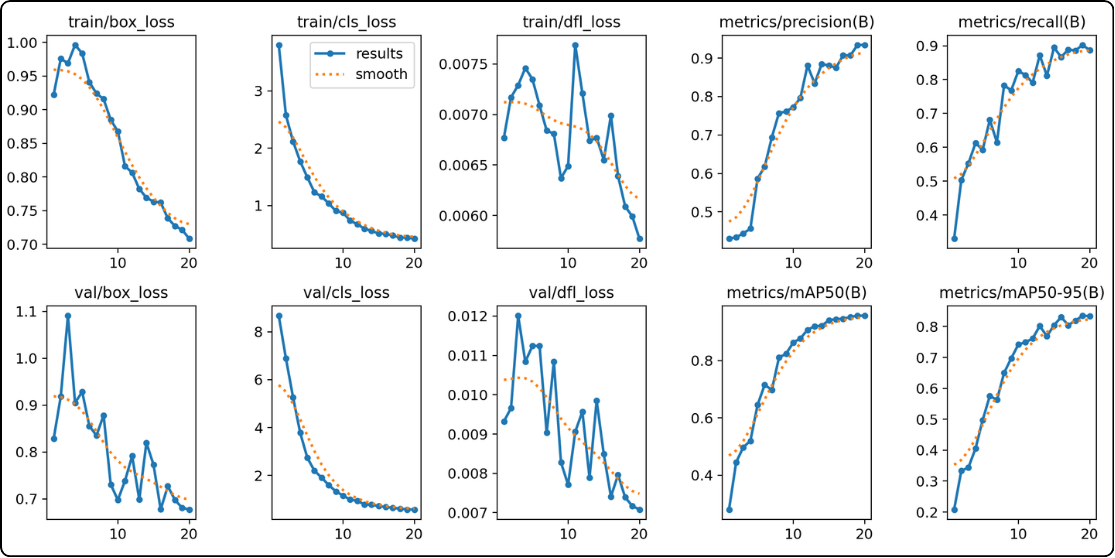
Les graphiques de résultats se divisent en deux groupes permettant d'évaluer la convergence et l'efficacité du modèle :
- les six courbes de gauche (les loss) : le modèle apprend et fait moins d’erreurs
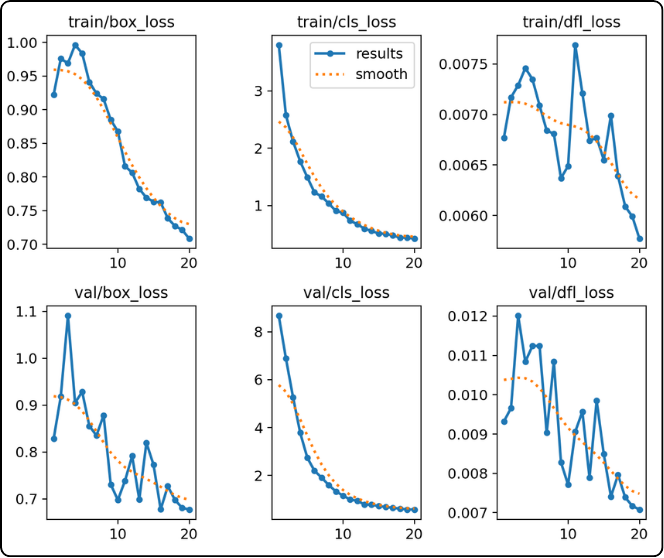
Les courbes de métriques (deux colonnes de droite) : Précision, Rappel, mAP50 et mAP50-95 illustrent la montée en compétence du modèle. L'objectif est d'observer la progression de ces courbes jusqu'à l'atteinte d'un plateau. Une stabilisation indique que le modèle a atteint son potentiel maximal et que l'entraînement peut cesser. À l'inverse, une croissance continue suggère qu'un prolongement de l'entraînement est nécessaire.
- les quatre courbes de droite (precision, recall, mAP50, mAP50-95) : le modèle devient plus performant
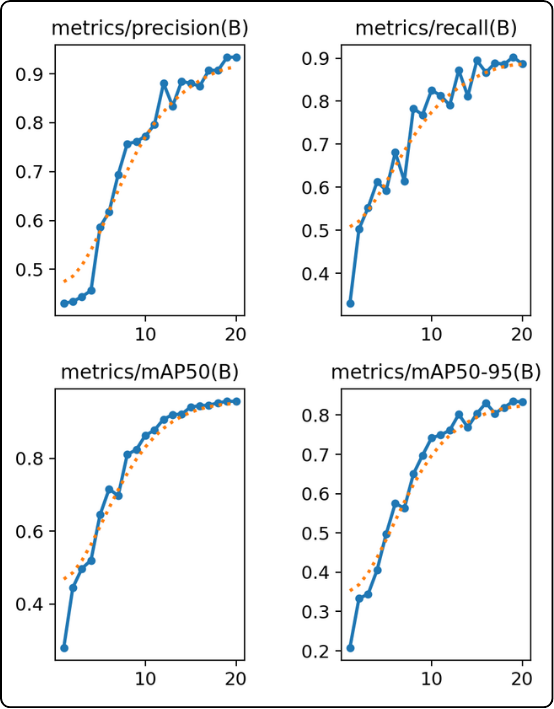
Les courbes de perte (trois colonnes de gauche) : Elles montrent l'évolution de l'erreur (loss) durant l'entraînement et la validation. Une décroissance simultanée de ces deux courbes est le signe idéal d'un modèle qui apprend correctement et généralise bien ses acquis.
POUR ALLER PLUS LOIN
Le surapprentissage survient lorsque le modèle mémorise par cœur les données d'entraînement au lieu d'apprendre des motifs généralisables. Il devient alors incapable de performer sur de nouvelles données.
- Détection visuelle : Ce phénomène se repère par une divergence des courbes de perte. Si la courbe d'entraînement (haut) continue de descendre alors que celle de validation (bas) remonte, le modèle surapprend. La courbe de validation agit comme un témoin neutre, car le modèle ne s'entraîne pas sur ces données.
- Gestion automatique et ressources : YOLO atténue ce risque en sauvegardant deux versions :
last.pt(état final, potentiellement surappris) etbest.pt(meilleurs poids enregistrés avant la dégradation de la validation). Bien quebest.ptgarantisse la performance, le surapprentissage reste une consommation inutile de temps et d'énergie de calcul. - Optimisation via le paramètre
patience: Pour éviter ce gaspillage, il est recommandé d'utiliser le paramètrepatience. Celui-ci arrête automatiquement l'entraînement si aucune amélioration n'est détectée sur la validation après un nombre défini d'époques, assurant ainsi que le processus s'interrompt dès que le modèle atteint son optimum.