Résumé de section
-
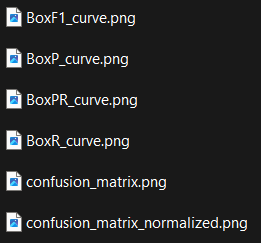
En vision par ordinateur, on utilise beaucoup l’outil “matrice de confusion” et on peut en déduire beaucoup de statistiques pertinentes pour évaluer un modèle.
On va devoir passer par une partie théorique avant de pouvoir comprendre ce que l’on voit dans les fichiers ci-dessus.
Pour notre partie théorique, nous nous mettrons dans le cas où nous essayons de détecter des pièces anglaise appelées "penny".
MATRICE DE CONFUSION
Une matrice de confusion est un tableau qui va synthétiser et trier les prédictions du modèle pour pouvoir les analyser.
Ici, il faut faire la distinction entre ce qui vrai et ce qui a été prédit. Un objet appartient à une classe, c'est ce qu'on appelle la vérité terrain (un chat appartient à la classe "chat").D'autre part, le modèle va faire des prédictions en attribuant une classe à un objet. Mais le modèle peut se tromper, ce qu'il prédit ne correspond pas forcément à la réalité (le chat peut finir dans la classe "chien" par exemple).On va donc distinguer :- la vérité terrain : la vraie classe des objets
- les prédictions : les résultats du modèle
Dans chacune de ces deux catégories on a deux résultats possibles : positif (présence de penny) et négatif (absence de penny).
Cela crée quatre combinations possibles :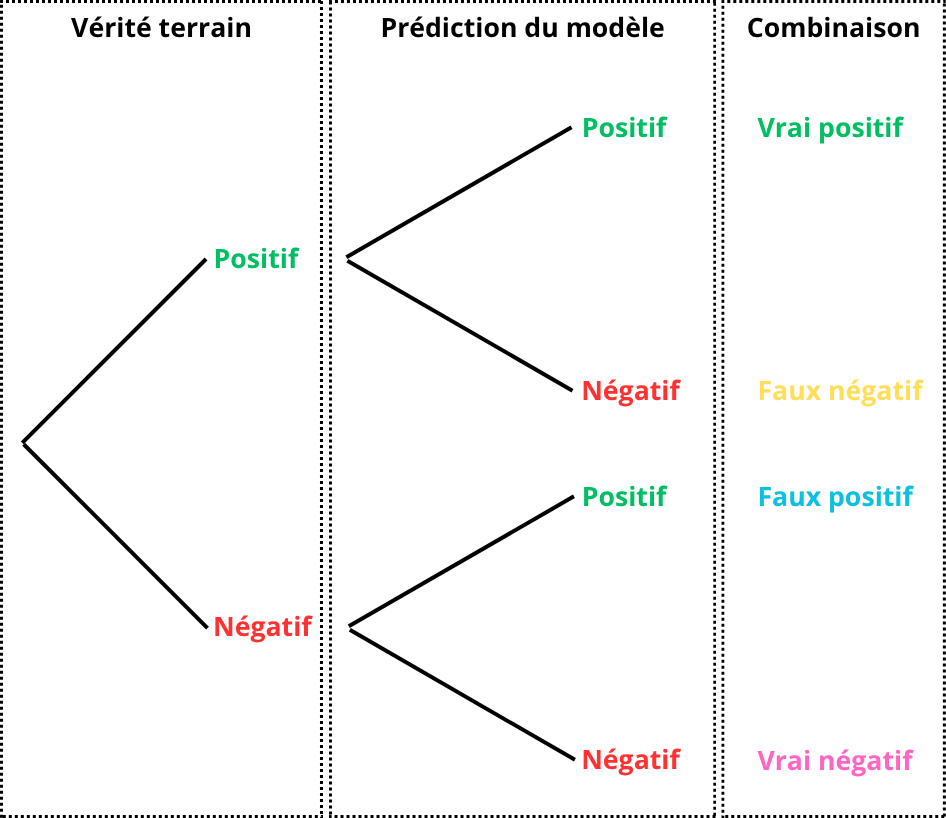
Pour une lecture plus simple, ces quatre combinaisons sont rassemblées dans un tableau à deux entrées. Les lignes correspondent à ce que le modèle a prédit et les colonnes correspondent à la vérité terrain.
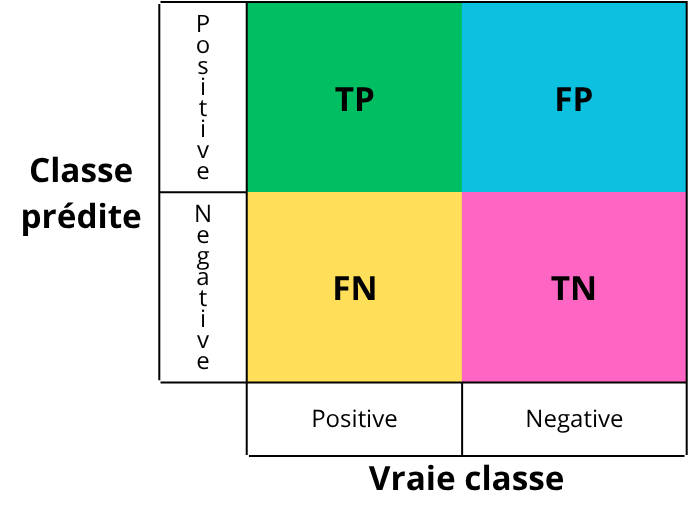
- TP : True Positive (vrai positif)
- Ce qui était à détecter et qui a bien été détecté.
- Exemple : il y avait un “penny” et il a bien été détecté.
- TN : True Negative (vrai négatif)
- Ce qui n’était pas à détecter et qui n’a pas été détecté.
- Exemple : il n’y avait pas de “penny” et aucun “penny” n’a été détecté.
- FP : False Positive (faux positif)
- Ce qui aurait dû être détecté comme négatif mais a été détecté comme positif.
- Exemple : il n’y avait pas de “penny” mais un “penny” a été détecté.
- FN : False Negative (faux négatif)
- Ce qui aurait dû être détecté comme positif mais a été détecté comme négatif.
- Exemple : il y avait un “penny” mais il n’a pas été détecté.
Pour remplir chaque case de cette matrice, on va compter le nombre d'instances de chaque combinaison.
EXEMPLE
L'image ci-dessous correspond à la vérité terrain, c’est-à-dire aux annotations faites à la main donc ce que le modèle est censé trouver :
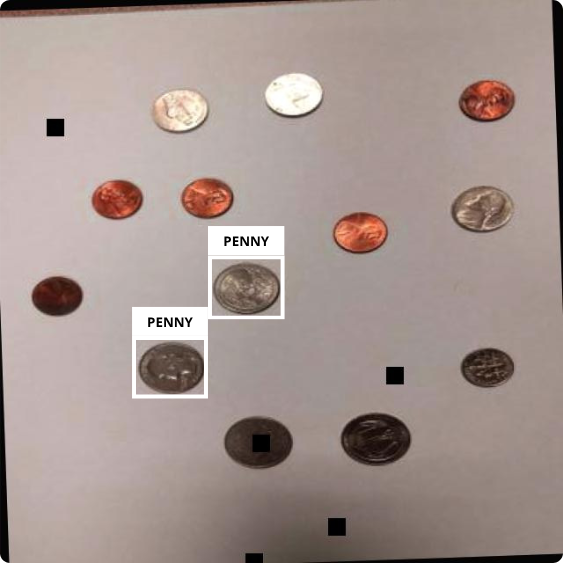
L'image suivante correspond aux détections faites par le modèle sur la même image après l’entrainement :
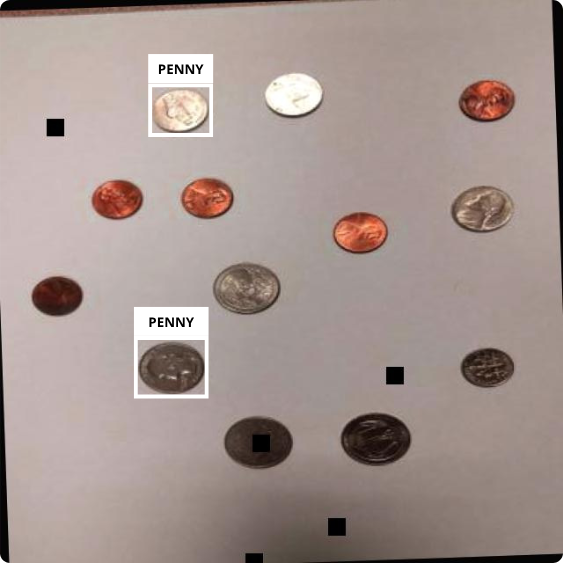
Si on fait le jeu des 7 erreurs entre les deux images :
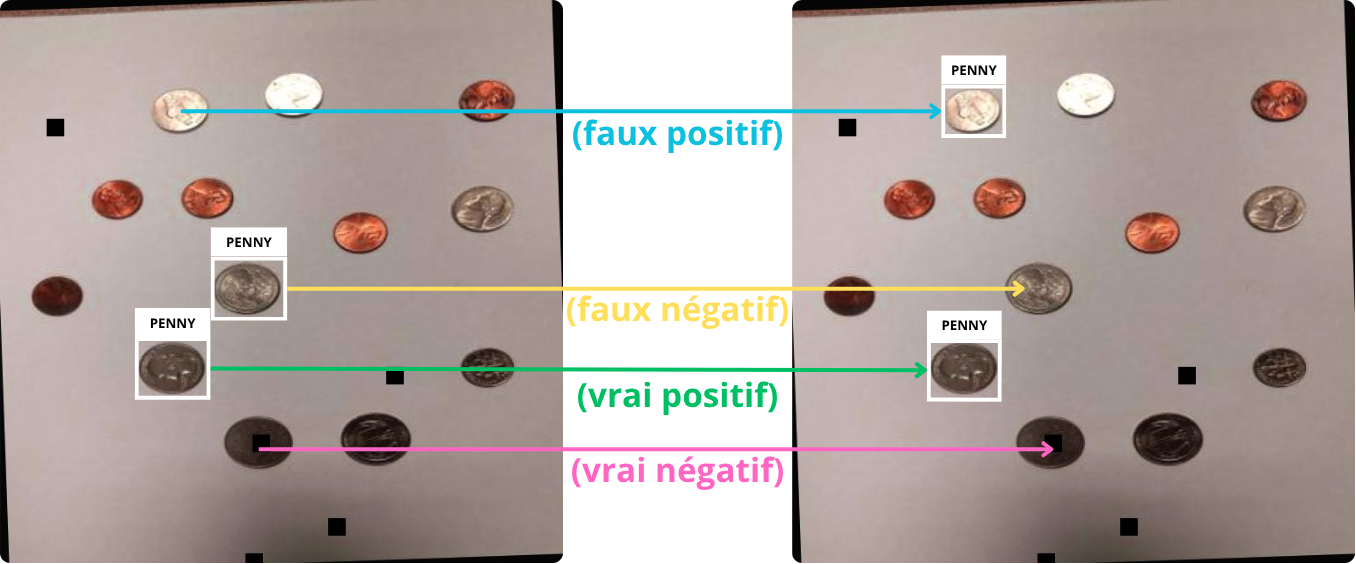
On remplit ensuite la matrice de confusion avec chaque instance :
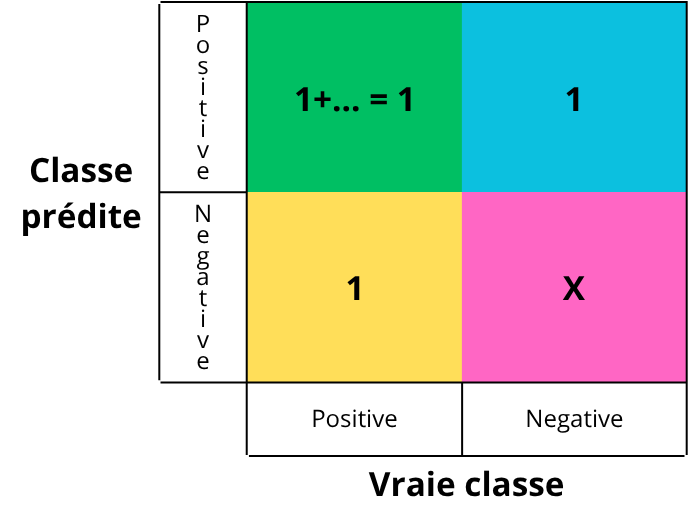
On remplit chaque case en comptant le nombre total d'occurrence de chaque évènement, donc dans le cas très scolaire ci-dessous, il y en une de chaque. Concernant les vrais négatifs, on ne les compte pas. En effet, pour de la détection, un vrai négatif n’a pas vraiment de sens, ça revient à dire : il n’y avait rien à détecter et rien n’a été détecté, mais à l’échelle d’une image, cela se transforme vite en bruit, c’est-à-dire que chaque pixel pourrait être un vrai négatif avec cette définition, donc on ne les prend pas en compte.
À partir de cette matrice, on peut tirer plusieurs métriques pour caractériser notre modèle. Ultralytics nous sort 4 courbes : précision-confiance, rappel-confiance, précision-rappel et score F1. On va voir comment les interpréter, mais commençons par définir chaque terme.
CONFIANCE
Lorsque le modèle fait une prédiction, il fourni avec sa détection une valeur traduisant la certitude de sa prédiction, une probabilité. Cette valeur, comprise entre 0 et 1 est ce qu’on appelle la confiance (1 étant la certitude absolue).
Il y a donc une nécessité de choisir une valeur seuil pour permettre au modèle de trancher. Si la confiance de la détection est supérieure, la détection est acceptée (l’objet est labellisé “penny”), sinon, elle est rejeté (l’objet est labellisé “background”/negative).
EXEMPLE
Prenons le graphique ci-dessous comme exemple :
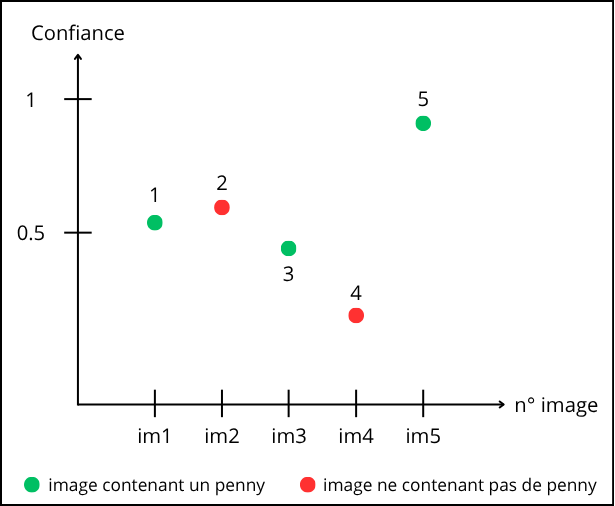
Lecture du graphique : le point “1” correspond à la prédiction faite sur l’image 1. Le point est vert donc sur l’image il y a un penny. On peut lire en ordonnée que le modèle détecte la présence d’un penny avec une confiance d’environ 0.55.
Autre exemple : le point “2” correspond à la prédiction faite sur l’image 2. Le point est rouge donc sur l’image il n’y a pas de penny. On peut lire en ordonnée que le modèle détecte la présence d’un penny avec une confiance d’environ 0.6.
Choisissons arbitrairement un seuil à 0.5. Visuellement, cela revient à tracer un trait horizontal là où la confiance vaut 0.5, puis on “accepte” tous les points au dessus et on “rejette” tous les points en dessous :
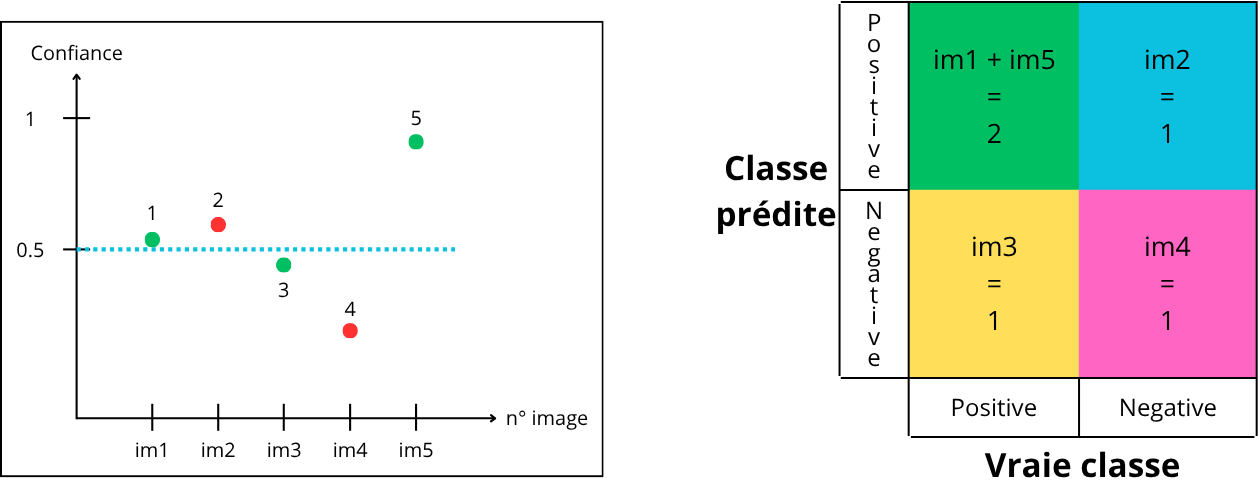
Comment remplir la matrice :
- le point “1” est au dessus du seuil de confiance donc prédit positif (contenant un penny) et est vert (contient bien un penny) → vrai positif (True Positive, TP)
- le point “2” est au dessus du seuil de confiance donc prédit positif (contenant un penny) et est rouge (ne contient pas de penny) → faux positif (False Positive, FP)
- le point “3” est en dessous du seuil de confiance donc prédit négatif (ne contenant pas de penny) et est vert (contient bien un penny) → faux négatif (False Negative, FN)
- le point “4” est en dessous du seuil de confiance donc prédit négatif (ne contenant pas de penny) et est rouge (ne contient pas de penny) → vrai négatif (True Negative, TN)
- le point “5” est au dessus du seuil de confiance donc prédit positive (contenant un penny) et est vert (contient bien un penny) → vrai positif (True Positive, TP)
Maintenant, prenons un seuil de 0.75, par le même procédé, on aura :
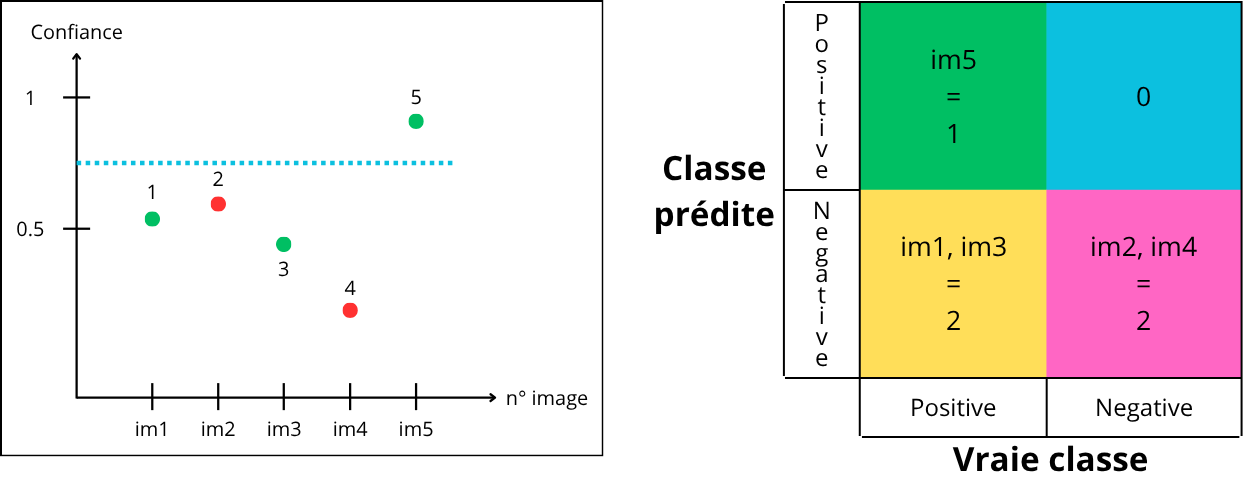
- le point “1” est en dessous du seuil donc prédit négatif mais vert → faux négatif (False Negative, FN)
- le point “2” est en dessous du seuil donc prédit négatif et est rouge → vrai négatif (True Negative, TN)
- le point “3” est en dessous du seuil donc prédit négatif mais est vert → faux négatif (False Negative, FN)
- le point “4” est en dessous du seuil donc prédit négatif et est rouge → vrai négatif (True Negative, TN)
- le point “5” est au dessus du seuil donc prédit positive et est vert → vrai positif (True Positive, TP)
Enfin, prenons un seuil de 0.35 :
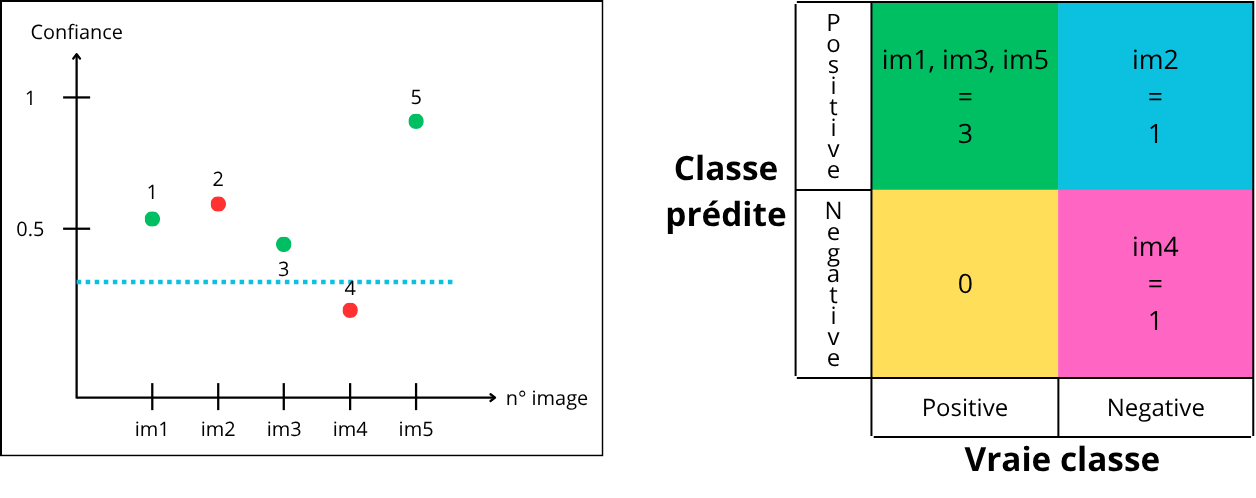
- le point “1” est au dessus du seuil donc prédit positif et est vert → vrai positif (True Positive, TP)
- le point “2” est au dessus du seuil donc prédit positif mais est rouge → faux positif (False Positive, FP)
- le point “3” est au dessus du seuil donc prédit positif et est vert → vrai positif (True Positive, TP)
- le point “4” est en dessous du seuil donc prédit négatif et est rouge → vrai négatif (True Negative, TN)
- le point “5” est au dessus du seuil donc prédit positive et est vert → vrai positif (True Positive, TP)
Pour un même modèle, on peut donc voir qu’il y a plusieurs matrices de confusion possibles, directement liées à la valeur du seuil de confiance choisi :
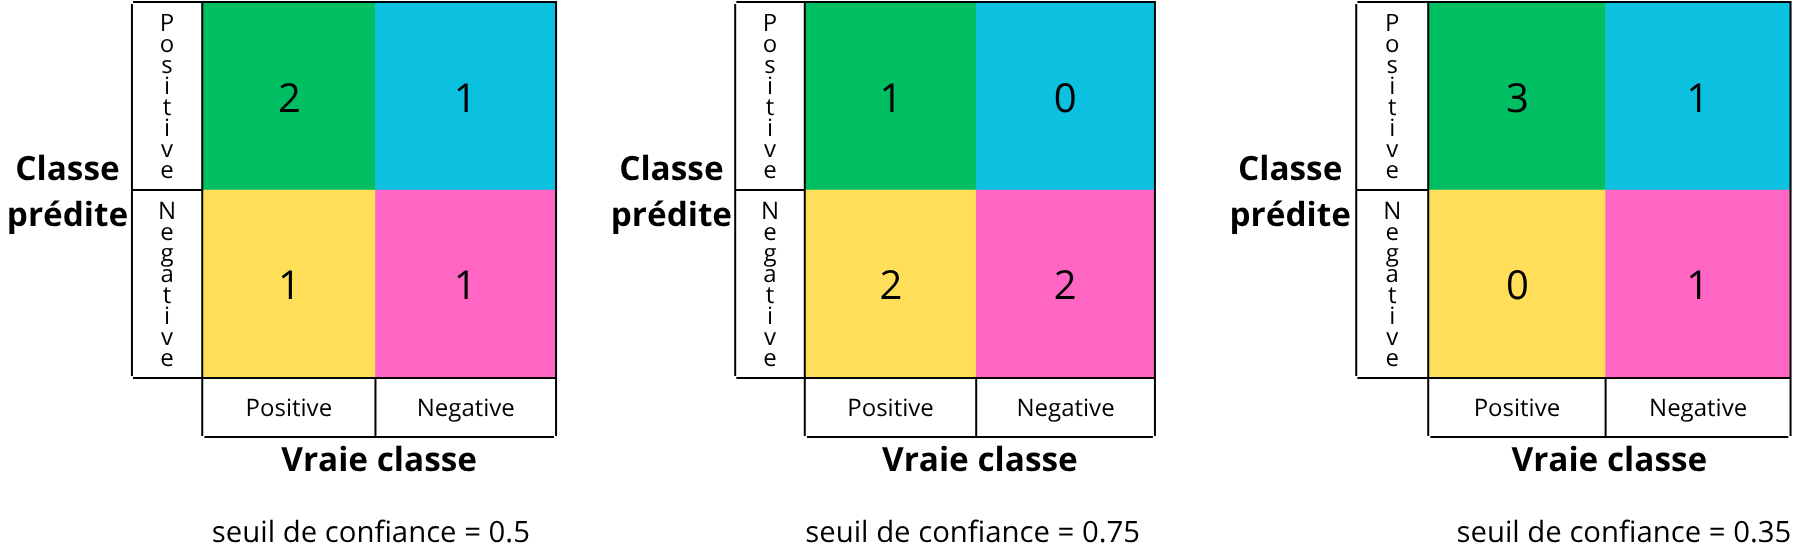
Il existe une infinité de matrices de confusion, correspondant à la continuité des seuils de confiance possibles entre 0 et 1. Cette matrice constitue l'indicateur principal pour évaluer la pertinence du seuil sélectionné en vue du déploiement du modèle.
L'optimisation d'une matrice de confusion exige souvent un compromis, car la réduction simultanée des faux positifs et des faux négatifs est rarement possible. Le choix du seuil dépend alors de la criticité des erreurs : en médecine, par exemple, on privilégie l'élimination des faux négatifs (pathologies non détectées) au détriment des faux positifs, moins graves. Des métriques quantitatives sont ensuite nécessaires pour identifier objectivement le seuil de confiance optimal arbitrant ce compromis.