Résumé de section
-
Dans un contexte multi-classes, la matrice de confusion s'étend pour inclure une ligne et une colonne par catégorie, plus une dimension « background » (négatif) représentant l'absence d'objet. Les lignes indiquent les prédictions et les colonnes la vérité terrain.
La diagonale principale conserve sa signification de prédictions correctes. Les erreurs de classification occupent désormais l'ensemble des cellules hors diagonale. La colonne "background" recense les fausses détections (objets prédits mais absents), tandis que la ligne "background" identifie les objets réels non détectés.
Pour calculer les métriques de performance (précision, rappel, score F1) et déterminer le seuil de confiance optimal, il est nécessaire de décomposer cette matrice globale. L'analyse s'effectue selon une approche « un-contre-tous » : une matrice binaire 2x2 est générée pour chaque classe individuellement, isolant les vrais positifs, faux positifs, vrais négatifs et faux négatifs spécifiques à cette catégorie.
Déjà, nous n’avons pas besoin des vrais négatifs comme vu tout à l'heure.
Voyons comment trouver les trois restantes en prenant encore une fois la classe “Penny” comme exemple.
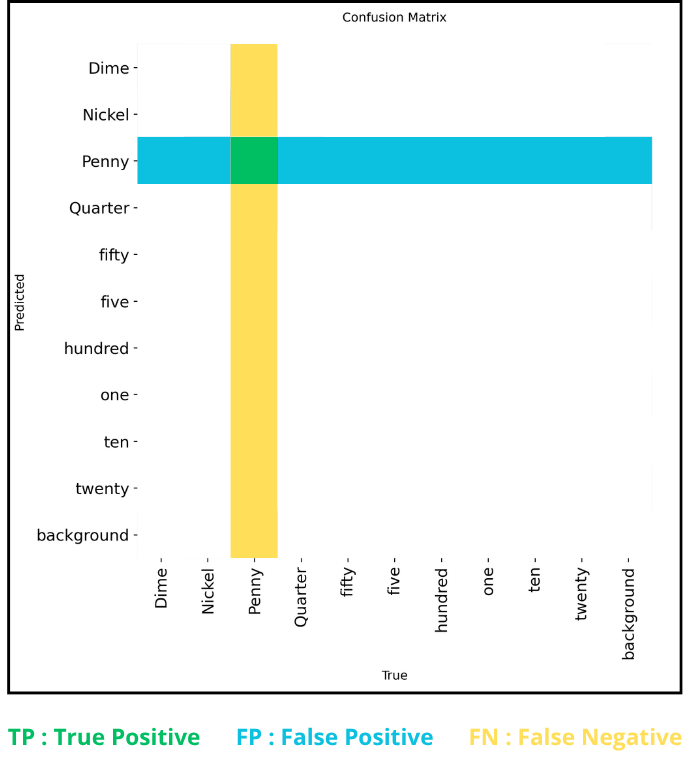
Pour une classe donnée (ex. : « penny »), les métriques se définissent ainsi à partir de la matrice :
- Vrais Positifs (TP) : Unique cellule à l'intersection de la ligne et de la colonne de la classe (diagonale).
- Faux Positifs (FP) : Somme de toutes les autres cellules de la ligne de la classe (prédites comme la classe mais appartenant à une autre).
- Faux Négatifs (FN) : Somme de toutes les autres cellules de la colonne de la classe (appartenant à la classe mais prédites comme une autre).
Ces valeurs permettent de calculer la précision et le rappel pour un seuil de confiance spécifique, chaque matrice de confusion correspondant à un seuil unique ; la répétition de ce calcul sur l'ensemble des seuils possibles génère ainsi les courbes de performance. Ce processus itératif est répété pour chaque classe, produisant autant de courbes individuelles. Une courbe de synthèse, dite « moyenne » (représentée en gras sur les graphiques), est ensuite dérivée de l'agrégation de l'ensemble des courbes par classe, offrant une vue globale de la performance du modèle.
À titre indicatif, la valeur optimale du seuil de confiance, correspondant à l'abscisse du maximum de la courbe F1, est directement indiquée dans la légende, immédiatement après la mention « all classes ».
MATRICE DE CONFUSION MULTI-CLASSE NORMALISÉE
Enfin, il reste la matrice de confusion normalisée. Elle permet d’avoir une vision globale car au lieu de donner les chiffres, elle donne des pourcentages.
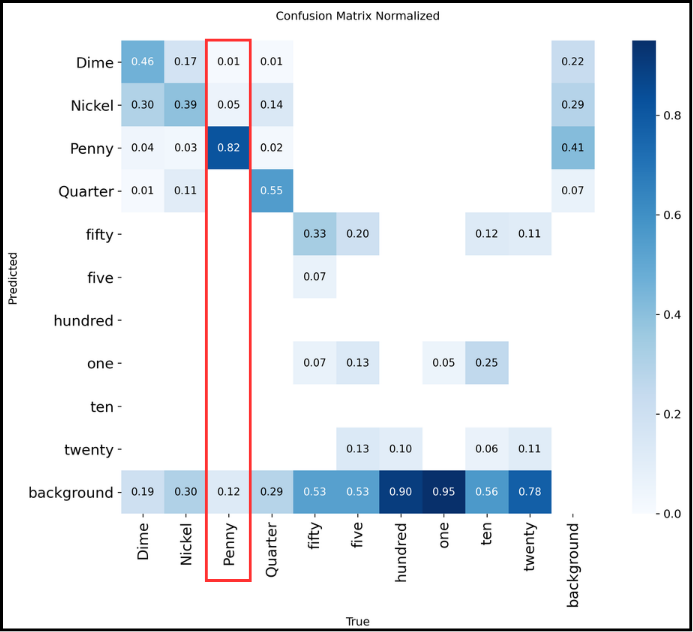
Comment la lire ?
La matrice de confusion normalisée permet de voir les pourcentages de détection pour chaque classe donc elle se lit colonne par colonne. Par exemple, pour les “Penny” de haut en bas :
- 1% ont été pris pour des “Dime”
- 5% ont été confondu avec des “Nickel”
- 82% des “Penny” ont bien été reconnu
- 12% n’ont pas du tout été détecté
On a bien 100% en faisant la somme donc c’est bon.