Résumé de section
-
-
-
À l'issue de l'entraînement, les résultats sont stockés dans le répertoire `runs/detect/train`, sauf configuration personnalisée d'un chemin alternatif. Ce dossier contient l'ensemble des artefacts nécessaires à l'évaluation de la performance du modèle et à son déploiement ultérieur.
Bien que cette section détaille l'interprétation complète des données générées, une analyse sommaire des critères de réussite est disponible directement dans la conclusion de ce chapitre. L'arborescence de ce répertoire comprend généralement les éléments suivants (sous réserve de légères variations selon la configuration) :
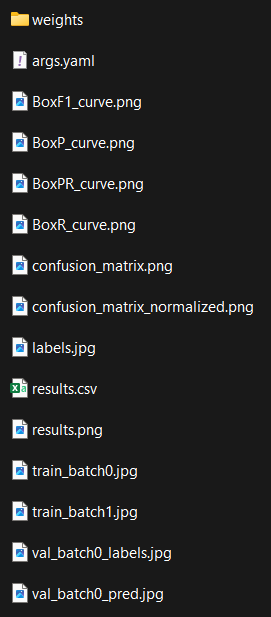 On va voir ce que représente chaque élément un a un.
-
-
-
Le dossier “Weights” correspond au fruit de votre labeur car dedans il y a les poids de votre modèle. C'est votre cerveau après apprentissage.
Il y a deux fichiers dedans : “best.pt” et “last.pt”. Cela se comprend de la manière suivante : les poids des neurones changent de manière régulière lors de l’entrainement et la qualité des poids est évaluée grâce à une fonction spécifique. Donc last.pt correspond aux derniers poids en date et best.pt correspond aux meilleurs poids qu’il y a eu de tout l’entrainement. On verra la subtilité d'avoir deux fichiers plus tard.

-
-
-
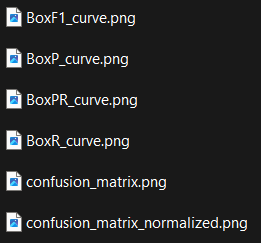
En vision par ordinateur, on utilise beaucoup l’outil “matrice de confusion” et on peut en déduire beaucoup de statistiques pertinentes pour évaluer un modèle.
On va devoir passer par une partie théorique avant de pouvoir comprendre ce que l’on voit dans les fichiers ci-dessus.
Pour notre partie théorique, nous nous mettrons dans le cas où nous essayons de détecter des pièces anglaise appelées "penny".
MATRICE DE CONFUSION
Une matrice de confusion est un tableau qui va synthétiser et trier les prédictions du modèle pour pouvoir les analyser.
Ici, il faut faire la distinction entre ce qui vrai et ce qui a été prédit. Un objet appartient à une classe, c'est ce qu'on appelle la vérité terrain (un chat appartient à la classe "chat").D'autre part, le modèle va faire des prédictions en attribuant une classe à un objet. Mais le modèle peut se tromper, ce qu'il prédit ne correspond pas forcément à la réalité (le chat peut finir dans la classe "chien" par exemple).On va donc distinguer :- la vérité terrain : la vraie classe des objets
- les prédictions : les résultats du modèle
Dans chacune de ces deux catégories on a deux résultats possibles : positif (présence de penny) et négatif (absence de penny).
Cela crée quatre combinations possibles :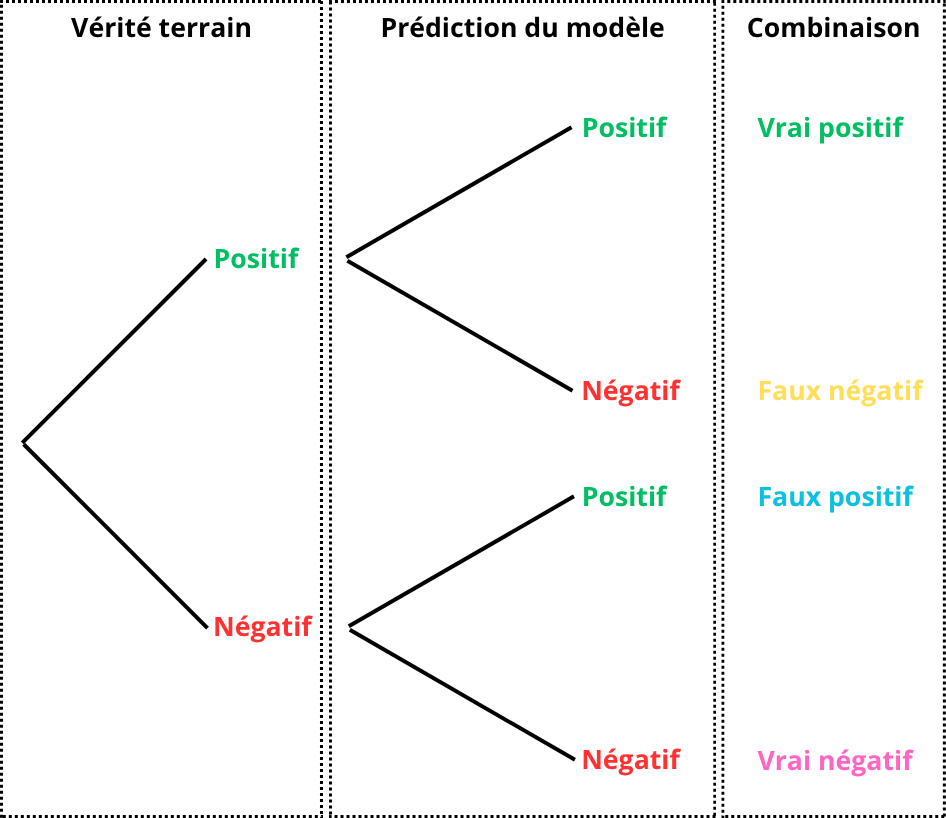
Pour une lecture plus simple, ces quatre combinaisons sont rassemblées dans un tableau à deux entrées. Les lignes correspondent à ce que le modèle a prédit et les colonnes correspondent à la vérité terrain.
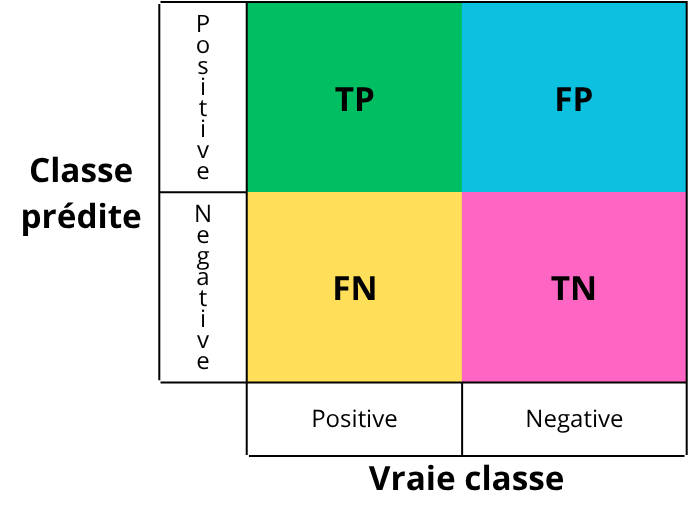
- TP : True Positive (vrai positif)
- Ce qui était à détecter et qui a bien été détecté.
- Exemple : il y avait un “penny” et il a bien été détecté.
- TN : True Negative (vrai négatif)
- Ce qui n’était pas à détecter et qui n’a pas été détecté.
- Exemple : il n’y avait pas de “penny” et aucun “penny” n’a été détecté.
- FP : False Positive (faux positif)
- Ce qui aurait dû être détecté comme négatif mais a été détecté comme positif.
- Exemple : il n’y avait pas de “penny” mais un “penny” a été détecté.
- FN : False Negative (faux négatif)
- Ce qui aurait dû être détecté comme positif mais a été détecté comme négatif.
- Exemple : il y avait un “penny” mais il n’a pas été détecté.
Pour remplir chaque case de cette matrice, on va compter le nombre d'instances de chaque combinaison.
EXEMPLE
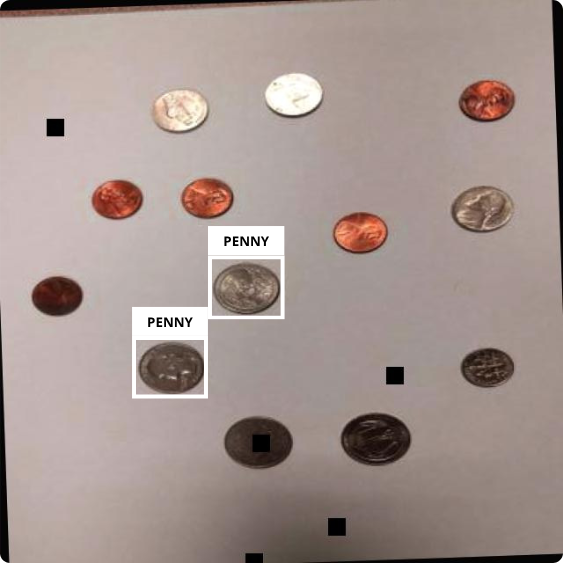
L'image ci-dessous correspond à la vérité terrain, c’est-à-dire aux annotations faites à la main donc ce que le modèle est censé trouver :
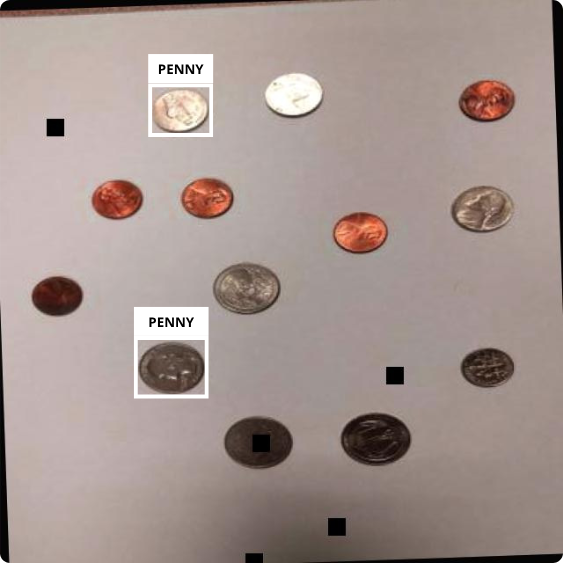
L'image suivante correspond aux détections faites par le modèle sur la même image après l’entrainement :
Si on fait le jeu des 7 erreurs entre les deux images :
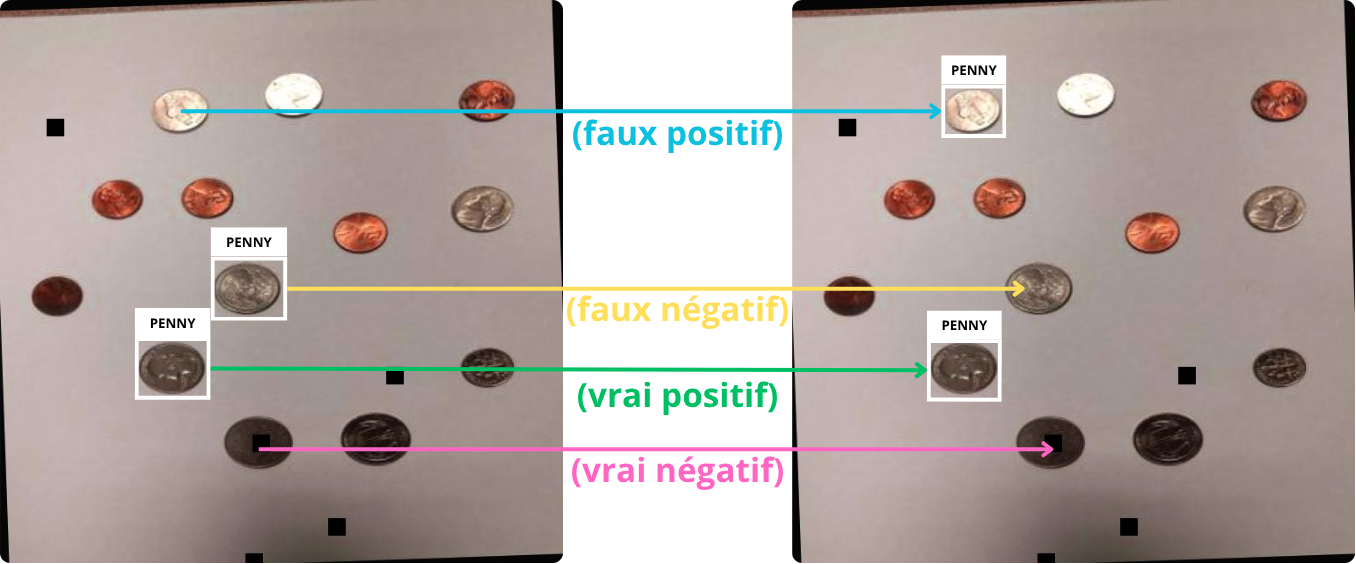
On remplit ensuite la matrice de confusion avec chaque instance :
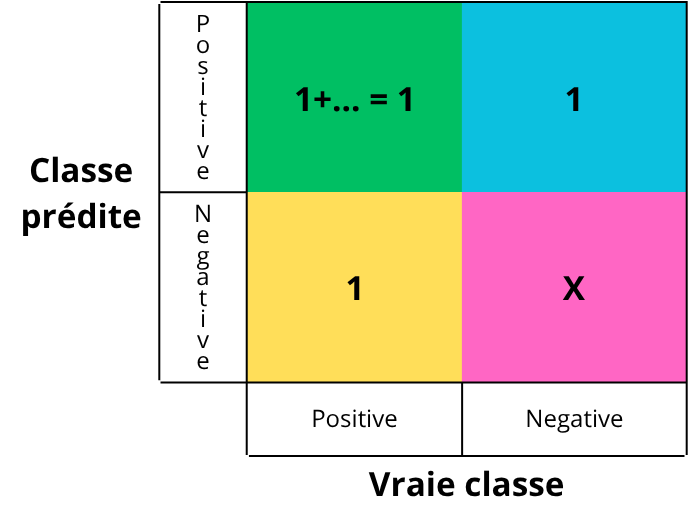
On remplit chaque case en comptant le nombre total d'occurrence de chaque évènement, donc dans le cas très scolaire ci-dessous, il y en une de chaque. Concernant les vrais négatifs, on ne les compte pas. En effet, pour de la détection, un vrai négatif n’a pas vraiment de sens, ça revient à dire : il n’y avait rien à détecter et rien n’a été détecté, mais à l’échelle d’une image, cela se transforme vite en bruit, c’est-à-dire que chaque pixel pourrait être un vrai négatif avec cette définition, donc on ne les prend pas en compte.
À partir de cette matrice, on peut tirer plusieurs métriques pour caractériser notre modèle. Ultralytics nous sort 4 courbes : précision-confiance, rappel-confiance, précision-rappel et score F1. On va voir comment les interpréter, mais commençons par définir chaque terme.
CONFIANCE
Lorsque le modèle fait une prédiction, il fourni avec sa détection une valeur traduisant la certitude de sa prédiction, une probabilité. Cette valeur, comprise entre 0 et 1 est ce qu’on appelle la confiance (1 étant la certitude absolue).
Il y a donc une nécessité de choisir une valeur seuil pour permettre au modèle de trancher. Si la confiance de la détection est supérieure, la détection est acceptée (l’objet est labellisé “penny”), sinon, elle est rejeté (l’objet est labellisé “background”/negative).
EXEMPLE
Prenons le graphique ci-dessous comme exemple :
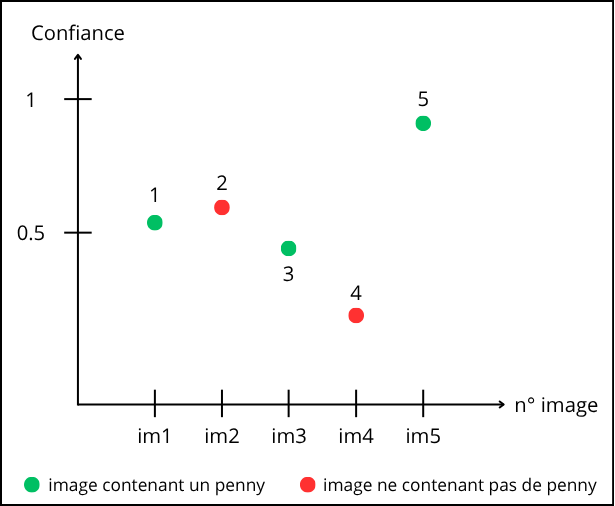
Lecture du graphique : le point “1” correspond à la prédiction faite sur l’image 1. Le point est vert donc sur l’image il y a un penny. On peut lire en ordonnée que le modèle détecte la présence d’un penny avec une confiance d’environ 0.55.
Autre exemple : le point “2” correspond à la prédiction faite sur l’image 2. Le point est rouge donc sur l’image il n’y a pas de penny. On peut lire en ordonnée que le modèle détecte la présence d’un penny avec une confiance d’environ 0.6.
Choisissons arbitrairement un seuil à 0.5. Visuellement, cela revient à tracer un trait horizontal là où la confiance vaut 0.5, puis on “accepte” tous les points au dessus et on “rejette” tous les points en dessous :
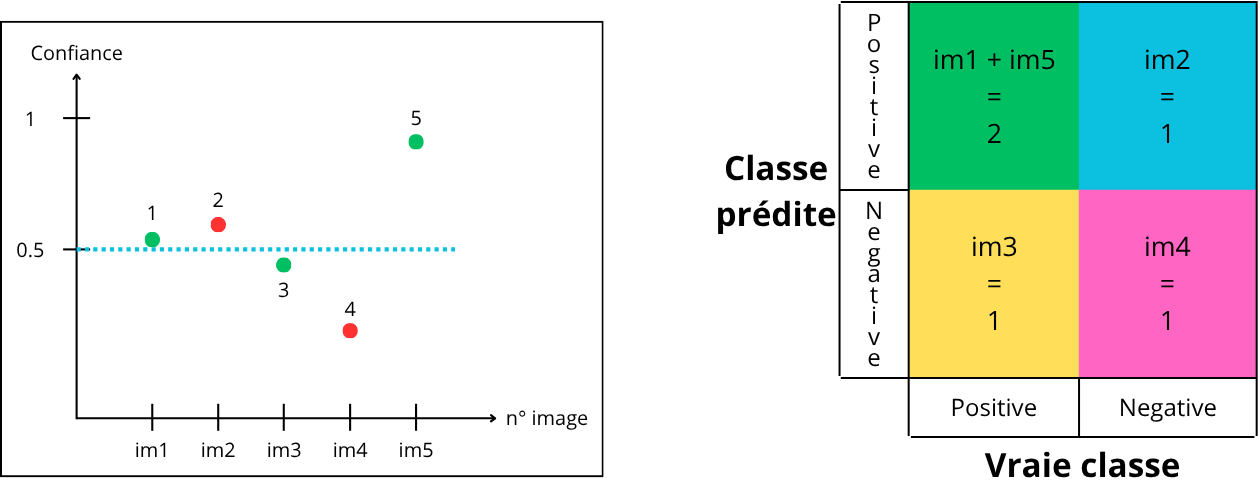
Comment remplir la matrice :
- le point “1” est au dessus du seuil de confiance donc prédit positif (contenant un penny) et est vert (contient bien un penny) → vrai positif (True Positive, TP)
- le point “2” est au dessus du seuil de confiance donc prédit positif (contenant un penny) et est rouge (ne contient pas de penny) → faux positif (False Positive, FP)
- le point “3” est en dessous du seuil de confiance donc prédit négatif (ne contenant pas de penny) et est vert (contient bien un penny) → faux négatif (False Negative, FN)
- le point “4” est en dessous du seuil de confiance donc prédit négatif (ne contenant pas de penny) et est rouge (ne contient pas de penny) → vrai négatif (True Negative, TN)
- le point “5” est au dessus du seuil de confiance donc prédit positive (contenant un penny) et est vert (contient bien un penny) → vrai positif (True Positive, TP)
Maintenant, prenons un seuil de 0.75, par le même procédé, on aura :
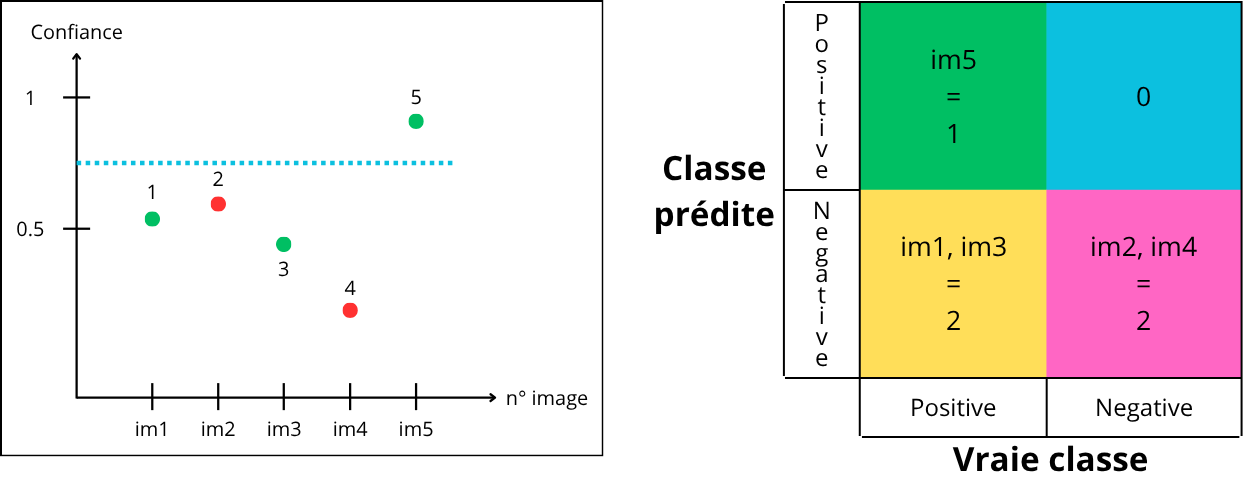
- le point “1” est en dessous du seuil donc prédit négatif mais vert → faux négatif (False Negative, FN)
- le point “2” est en dessous du seuil donc prédit négatif et est rouge → vrai négatif (True Negative, TN)
- le point “3” est en dessous du seuil donc prédit négatif mais est vert → faux négatif (False Negative, FN)
- le point “4” est en dessous du seuil donc prédit négatif et est rouge → vrai négatif (True Negative, TN)
- le point “5” est au dessus du seuil donc prédit positive et est vert → vrai positif (True Positive, TP)
Enfin, prenons un seuil de 0.35 :
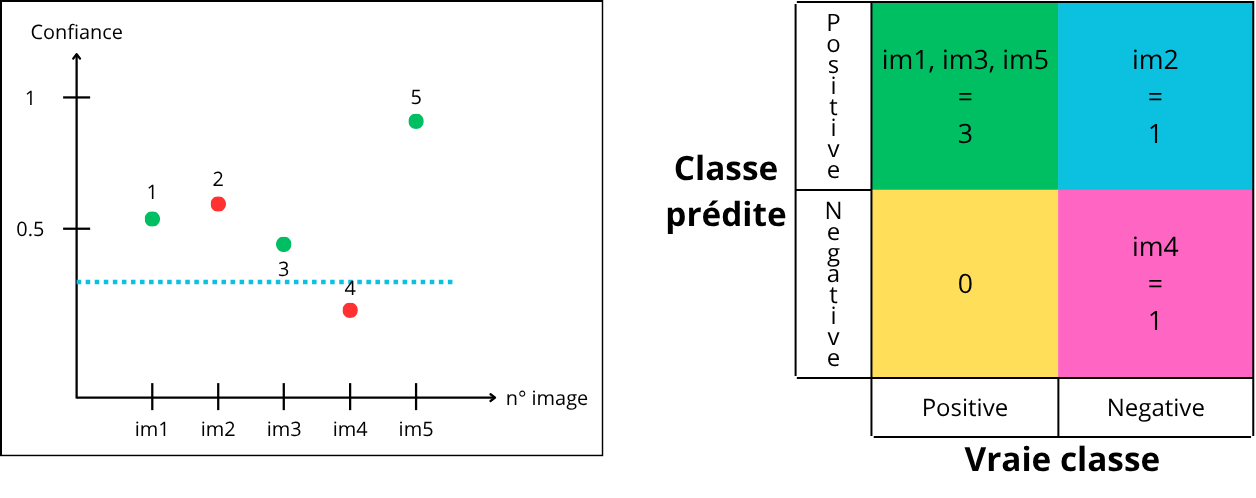
- le point “1” est au dessus du seuil donc prédit positif et est vert → vrai positif (True Positive, TP)
- le point “2” est au dessus du seuil donc prédit positif mais est rouge → faux positif (False Positive, FP)
- le point “3” est au dessus du seuil donc prédit positif et est vert → vrai positif (True Positive, TP)
- le point “4” est en dessous du seuil donc prédit négatif et est rouge → vrai négatif (True Negative, TN)
- le point “5” est au dessus du seuil donc prédit positive et est vert → vrai positif (True Positive, TP)
Pour un même modèle, on peut donc voir qu’il y a plusieurs matrices de confusion possibles, directement liées à la valeur du seuil de confiance choisi :
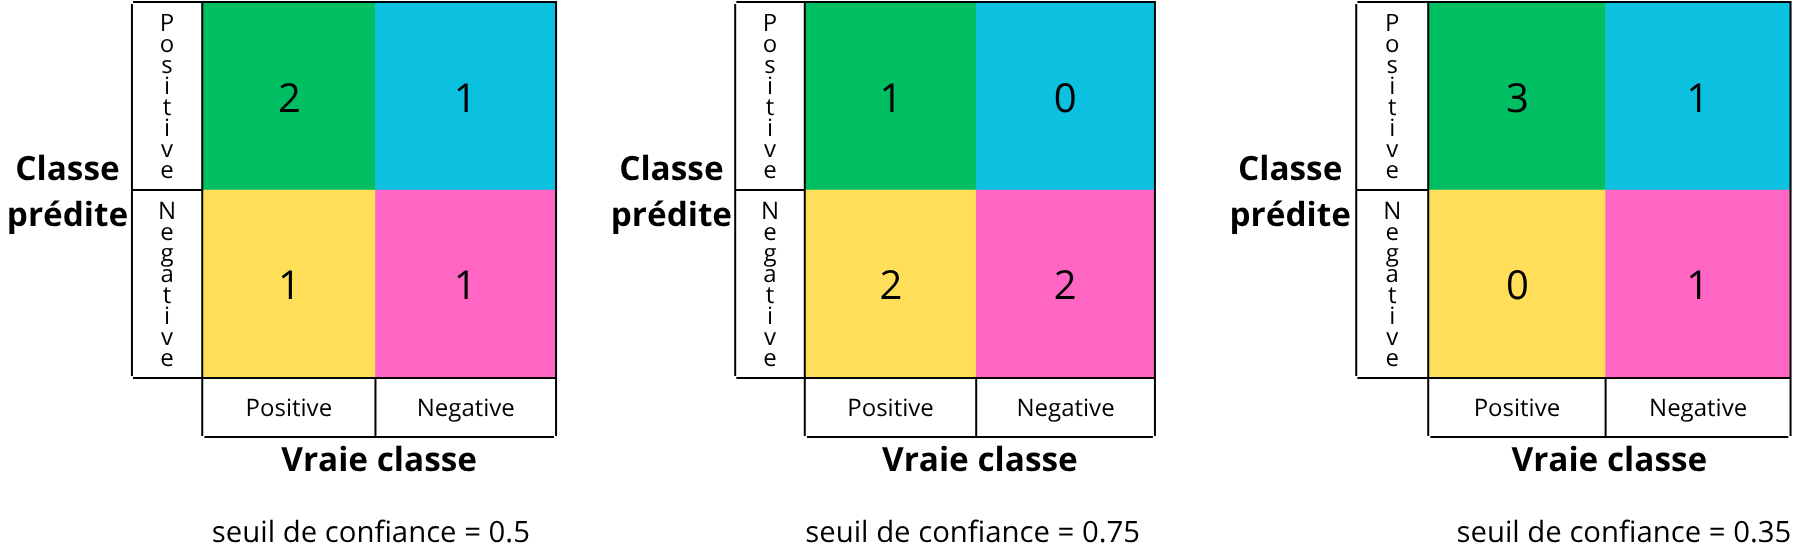
Il existe une infinité de matrices de confusion, correspondant à la continuité des seuils de confiance possibles entre 0 et 1. Cette matrice constitue l'indicateur principal pour évaluer la pertinence du seuil sélectionné en vue du déploiement du modèle.
L'optimisation d'une matrice de confusion exige souvent un compromis, car la réduction simultanée des faux positifs et des faux négatifs est rarement possible. Le choix du seuil dépend alors de la criticité des erreurs : en médecine, par exemple, on privilégie l'élimination des faux négatifs (pathologies non détectées) au détriment des faux positifs, moins graves. Des métriques quantitatives sont ensuite nécessaires pour identifier objectivement le seuil de confiance optimal arbitrant ce compromis.
-
-
-
Visualisons ces mesures grâce à un schéma :
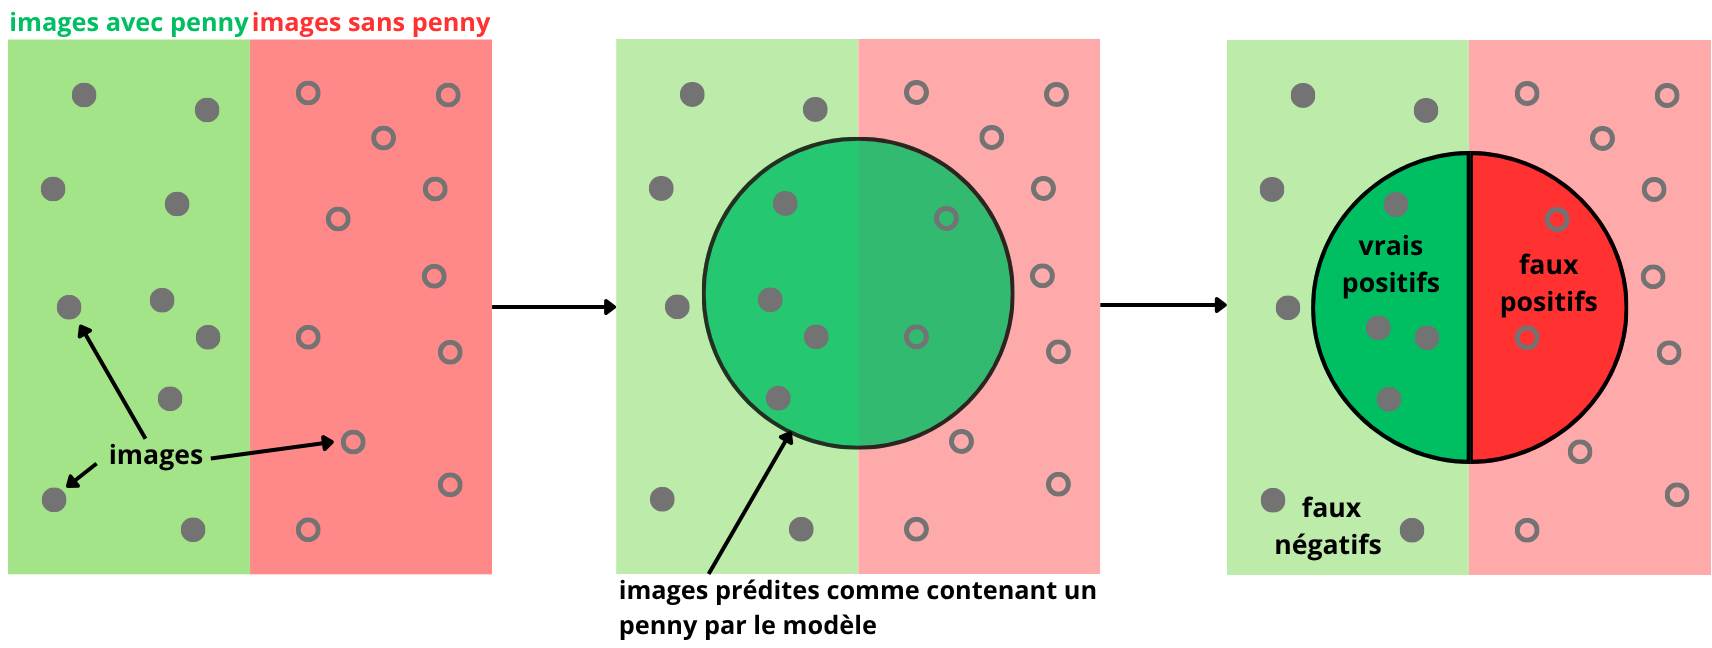
En utilisant le dernier schéma, on peut écrire la précision et le rappel comme ci-dessous :
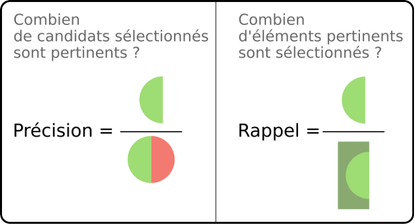
Donc mathématiquement, on peut formaliser de la façon suivante :


Il est donc possible d'en faire des courbes pour voir l'évolution des ces mesures en fonction du seuil de confiance.
PRÉCISION-CONFIANCE
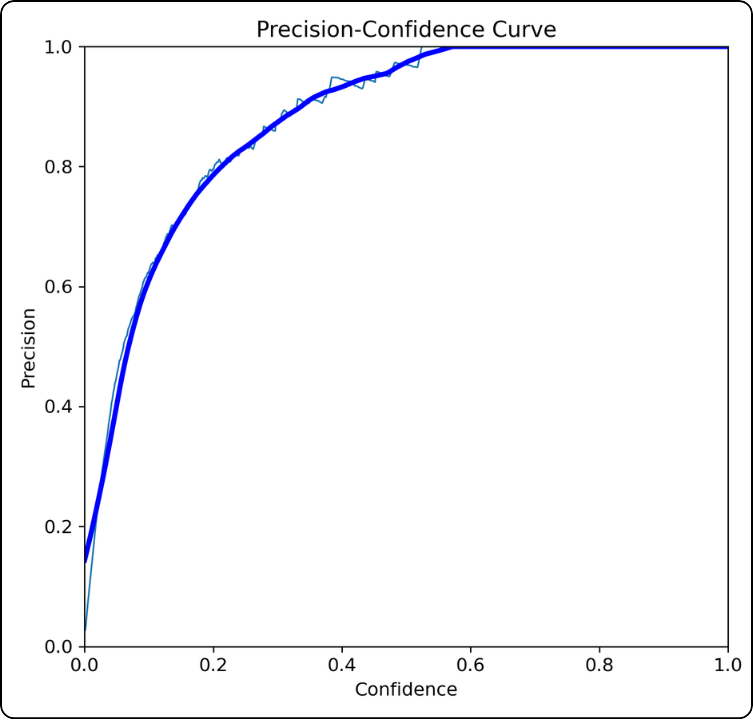
Comment la construire ? Pour tous les seuils de confiance compris entre 0 et 1 :
- on établit la matrice de confusion pour ce seuil
- on calcule la précision associée à cette matrice spécifique
- on place le point dans le graphique
À l’inverse, comment la lire ? Par exemple, pour un seuil de confiance de 0.4, on lit une précision de 0.92, on en déduit que pour un tel seuil on a assez peu de faux positifs.
À retenir : plus la courbe est haute, meilleure est la précision du modèle.
POUR ALLER PLUS LOIN
Il faut faire attention avec cette courbe car elle ne prend pas du tout en compte les faux négatifs, mais surtout, plus le seuil monte, de moins en moins de valeur sont prises en compte donc la montée de la précision est “artificielle”.
Cela s’explique car le modèle n’accepte quasiment plus rien, donc si il ne détecte que un vrai positif avec 98% de confiance et c’est tout, il aura donc 100% de précision. Mais dans ce cas, plein de “vrais positifs”, jugé négatifs car sous le seuil de confiance, seront oubliés.
RAPPEL-CONFIANCE
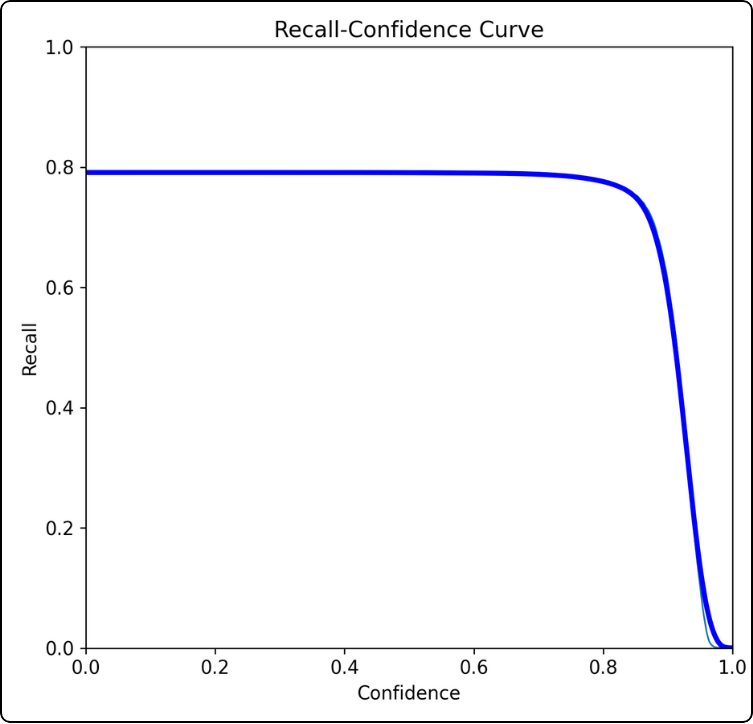
Comment la construire ? Pour tous les seuils de confiance compris entre 0 et 1 :
- on établit la matrice de confusion pour ce seuil
- on calcule le rappel associé à cette matrice spécifique
- on place le point dans le graphique
À l’inverse, comment la lire ? Par exemple, pour un seuil de confiance de 0.8, on lit un rappel de 0.78, on en déduit que pour un tel seuil on a beaucoup de faux négatifs.
À retenir : plus la courbe est haute et met du temps à descendre, meilleur est le rappel du modèle.
POUR ALLER PLUS LOIN
La courbe finira nécessairement à 0 car plus on augmente le seuil de confiance, plus le modèle est “strict”, il n’accepte que des prédictions dont il est sûr, donc le nombre de faux négatifs augmente drastiquement ce qui annule la fraction.
La précision et le rappel sont deux métriques intéressantes et complémentaires, c’est à dire que pour avoir une vision globale du modèle il faut regarder les deux en même temps mais surtout voir comment l’une évolue par rapport à l’autre.
Pour éviter de faire des va-et-vient entre les deux graphiques, des métriques les combinent directement, donc on introduit la courbe de précision-rappel et le score-F1 dans la prochaine section.
-
-
-
PRÉCISION-RAPPEL
La courbe de précision-rappel permet de voir l’évolution simultanément de la précision et du rappel selon le seuil de confiance. Elle est construite de manière très spéciale.
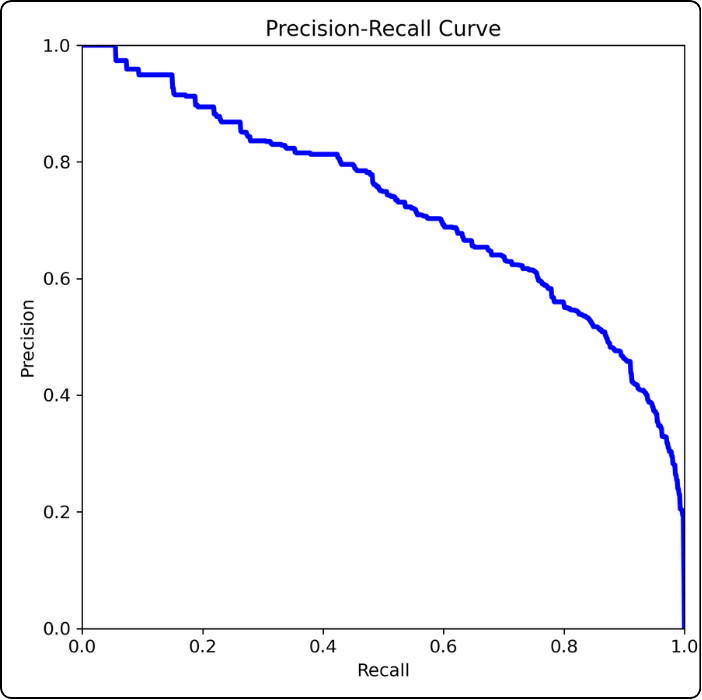
Comment la construire ? Cette courbe est construite point par point car une troisième dimension est cachée, le seuil de confiance.
On commence par le point le plus à gauche : ce point correspond à la valeur de la précision et du rappel lorsque le seuil de confiance est à 1.
On trace ensuite celui juste à sa droite : on prend le seuil 0.99 et on calcule la précision et le rappel depuis la matrice de confusion. Et ainsi de suite.
À l’inverse, comment la lire ? Prenons le point où le seuil de confiance est à 0.5 (si on prend la courbe à ses extrémités avec nos doigts et qu’on la tend, ce sera le milieu), on peut lire qu’à ce seuil, la précision est de 0.65 et le rappel à 0.67 (approximativement).
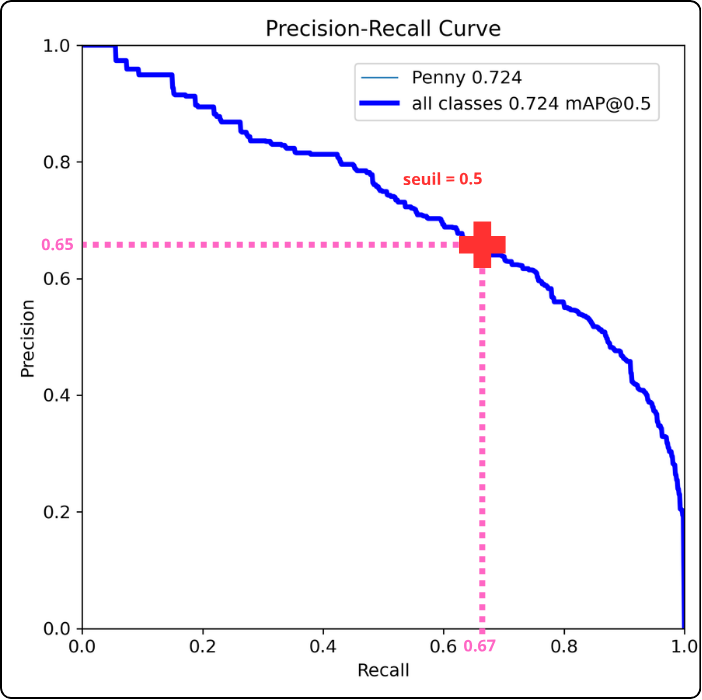
À retenir : plus la courbe monte dans le coin en haut à droite, meilleur est le modèle (le modèle ici est plutôt mauvais, ne vous y referez pas).
POUR ALLER PLUS LOIN
La courbe de précision-rappel est utilisée pour calculer une autre métrique que vous retrouverez à quelques endroits dans les résultats : Average Precision (AP). Cette métrique correspond à l’aire sous la courbe de précision-rappel. C’est la valeur décimal que l’on peut lire à côté du nom de la classe dans la légende.
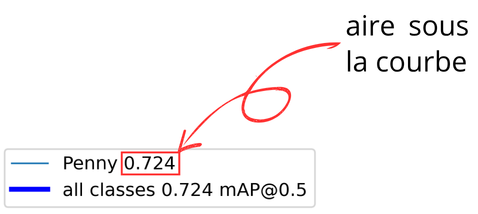
Par extension la mAP correspond à la mean Average Precision donc à la moyenne des AP quand on a plusieurs classes (nous en reparlerons plus tard).
Quel est l'utilité de cette mesure ? Comme mentionné dans le point "à retenir", plus la courbe monte en haut à droite, meilleur est le modèle mais "monter en haut à droite" est subjectif alors l'Average Precision a été introduite pour quantifier à quelle point la courbe monte donc à quel point l'aire sous la courbe est grande. Donc plus la valeur de la AP ou de la mAP est grande, meilleur est le modèle.
POUR ALLER ENCORE PLUS LOIN
Juste après “mAP”, vous pouvez lire “@0.5” ce qui correspond à la valeur seuil pour “l’Intersection over Union” (IoU).
Pour comprendre ce que c’est, il faut le voir comme l’outil de vérification du modèle : le modèle prédit une boite pour englober un objet et d’autre part, il a la boite de vérité terrain. Mais il a besoin de quantifier si sa boite à lui est bien placée par rapport à l’endroit exact où elle devait être, donc on introduit un nouvel outil que l’on va expliquer, l'IoU.
Prenons ces deux boites :
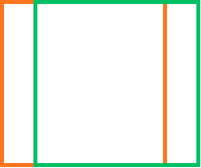
La boite verte correspond à la vérité terrain et la boite orange a la prédiction du modèle. Elle n’est pas placée idéalement pourtant elle semble quand même englober le même objet.
Donc pour avoir une valeur attestant de la précision du placement de la boite, on va calculer le rapport entre l’intersection des deux boites et leur union, comme schématisé ci-dessous :
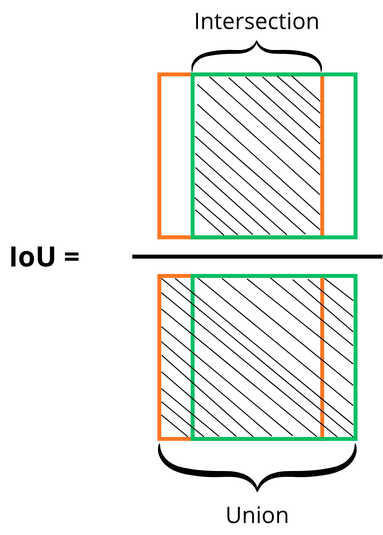
Il est nécessaire de choisir un seuil qui permet de rejeter ou garder une prédiction. Dans le cas précédent où on avait un seuil d'IoU à 0.5, cela revient à dire que si une boîte de prédiction ne recouvre pas la boite vérité terrain à au moins 50%, c’est qu’elle est mal placée donc non acceptée.
Quel est la différence entre la confiance et l'IoU ?
La confiance sert lorsque le modèle prédit alors que le seuil d'IoU sert lorsque le modèle vérifie ses prédictions.
Prenons le processus d'entrainement étape par étape :
Étape 1 : choix des valeurs des seuils de confiance et de IoU (arbitrairement) :
- seuil de confiance = 0.5
- seuil d’IoU = 0.5
Étape 2 : le modèle commence à s’entrainer, donc il regarde une image, puis fait des prédictions qui sont accompagnées chacune d’une confiance.
Étape 3 : d’après le seuil de confiance donné (0.5), le modèle accepte toutes les prédictions dont la confiance est supérieure et rejette les autres.
Étape 4 : vient ensuite la vérification des boîtes, donc comme pour le jeu des 7 erreurs de tout à l’heure, le modèle prend l’image avec les prédiction d’un côté et l’image avec la vérité terrain de l’autre puis compare. Chacune des boites prédites est comparée via l’IoU aux boites de vérité terrain, et si le ratio dépasse le seuil d'IoU (0.5), alors la boite est validée en tant que “vrai positif”. Sinon, si l’IoU est inférieure, la boite est rejetée mais comme elle avait passé le test de confiance, alors c’est une fausse alerte donc “faux positif”.
Étape 5 : enfin, une fois que tout est vérifié, les boites de la vérité terrain qui n’ont pas trouvé détection à leur pied se retrouve dans les “faux négatifs”.
La différence principale réside dans le fait que le seuil d'IoU ne sert que lors de l'entrainement car une fois déployé, le modèle ne se supervisera plus, il ne pourra pas. Alors que le seuil de confiance est crucial pour le déploiement du modèle.
L'étape 4 utilise la méthode de l'Intersection over Union comme juge de ses prédictions. Cette étape remplace une intervention humaine qui jugerait de la qualité de la prédiction.
Le schéma ci-dessous tente de synthétiser le processus d'entrainement d'un modèle :
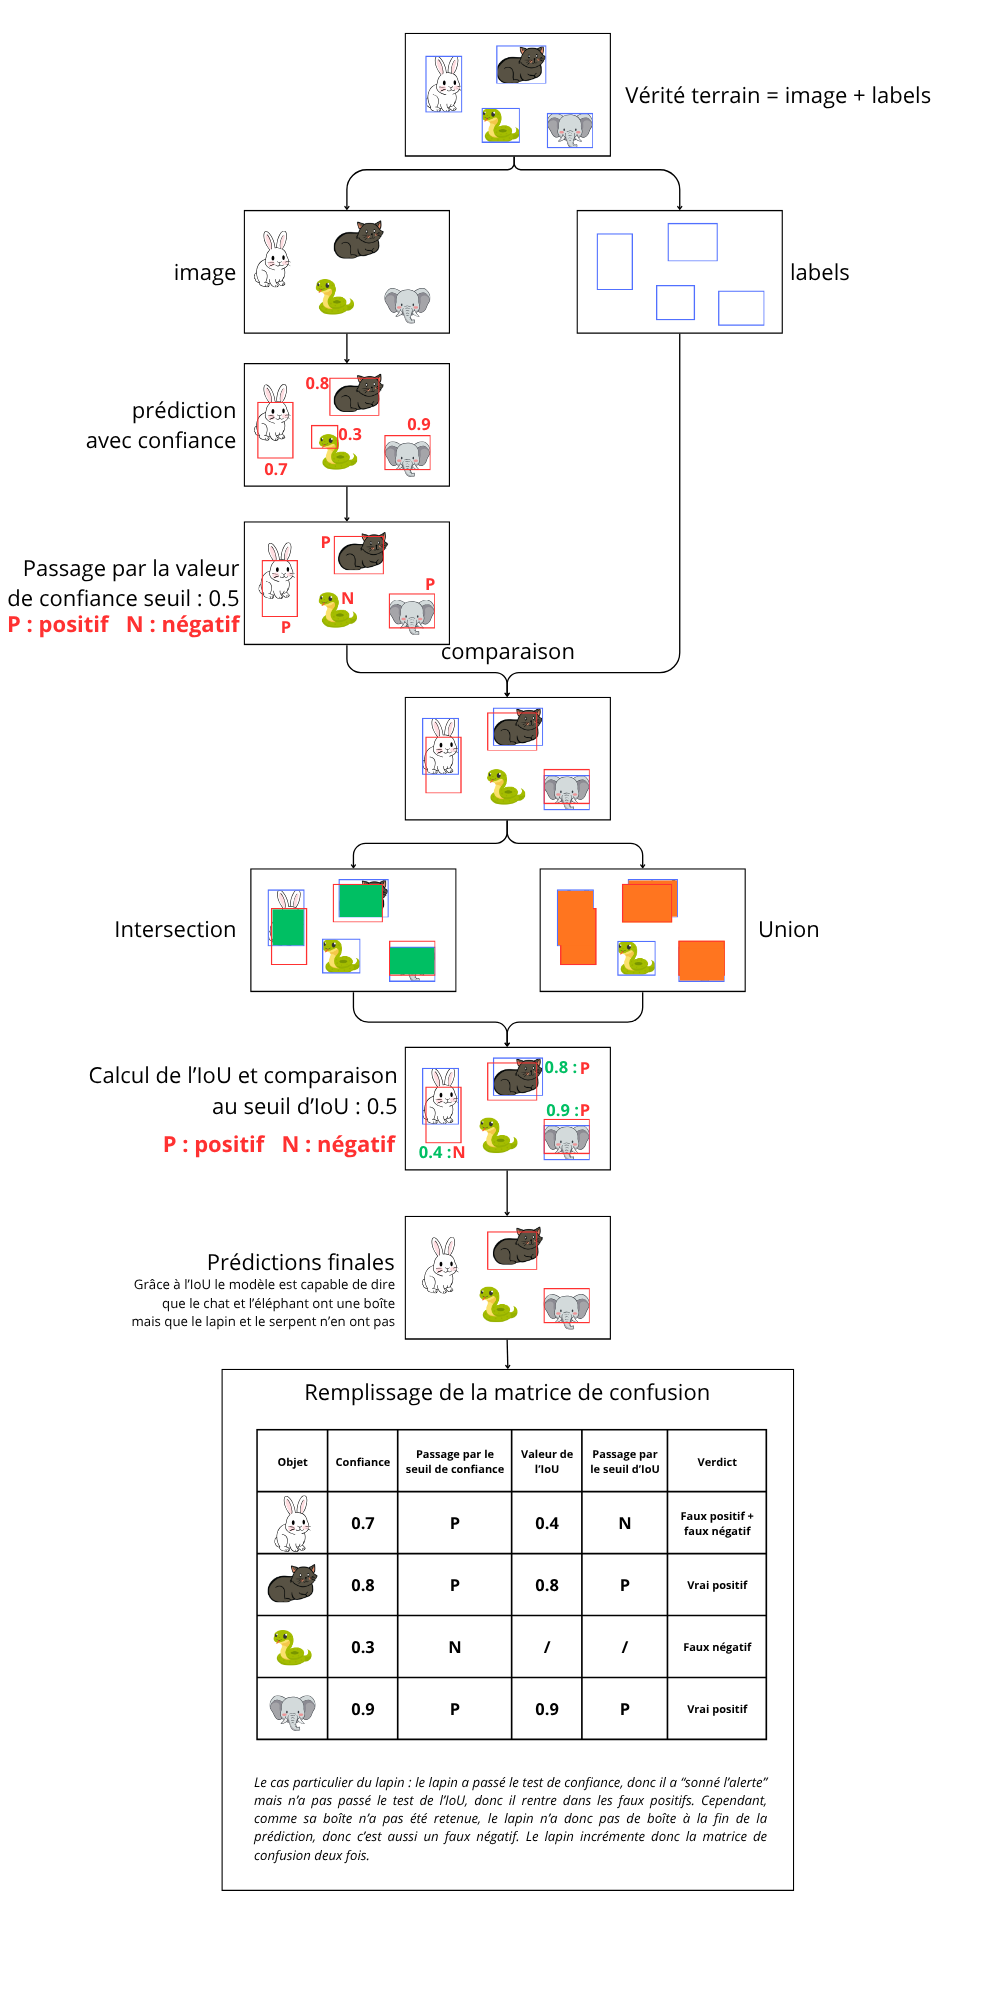
Sachez que vous pouvez choisir votre seuil d'IoU, donc en fonction de la précision nécessaire à votre projet, prenez un seuil plus ou moins haut. Un bonne fourchette est [0.5; 0.8], Ultralytics conseille de prendre une valeur comprise dans cet intervalle.
Enfin, il existe une dernière métrique que vous pourrez observer plus tard : la mAP50-95. Elle consiste à calculer la mAP pour toutes les valeurs de seuils d’IoU comprises entre 0.5 et 0.95 avec un pas de 0.05 (donc : 0.5, 0.55, 0.6, ..., 0.9, 0.95) et à en faire la moyenne.
Cette métrique est particulièrement intéressante car elle est exigeante en termes de précision de placement de la boite donc en regardant l’évolution de cette valeur, on peut voir si notre modèle englobe correctement. C’est une métrique très commune dans l’industrie de la vision par ordinateur.
F1-SCORE
Le F1-score est la moyenne harmonique de la précision et du rappel en fonction du seuil de confiance, donc correspond à la formule suivante :
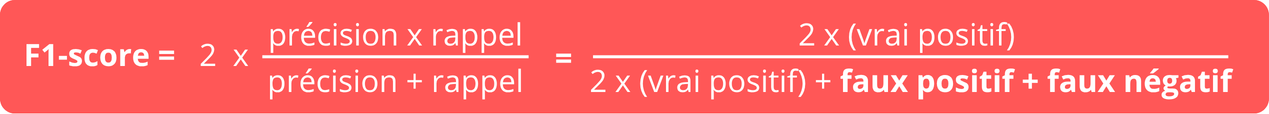
La courbe F1 permet de déterminer le seuil de confiance optimal pour le déploiement du modèle. En tant que moyenne harmonique de la précision et du rappel, le score F1 pénalise sévèrement les déséquilibres : une précision parfaite associée à un rappel nul engendre un score très faible, une nuance que les courbes classiques peuvent masquer.
Le seuil optimal correspond à l'abscisse du maximum de cette courbe, représentant le point d'équilibre idéal maximisant simultanément la précision et le rappel.
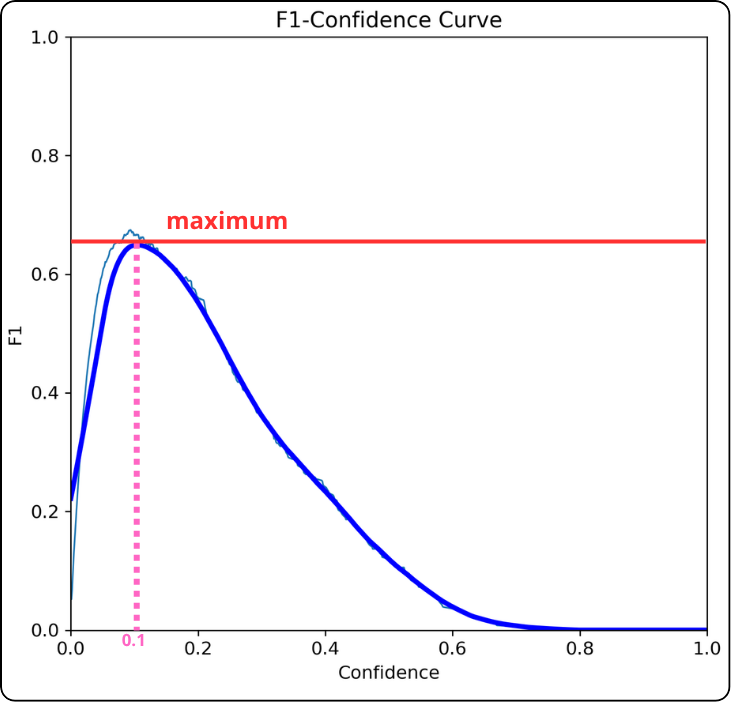
On trouve donc ici qu’un seuil de 0.1 de confiance serait optimal pour maximiser rappel et précision en même temps. (C’est un très mauvais modèle mais c’est juste pour l’exemple!)
À retenir : l'abscisse du maximum offre une bonne option de seuil de confiance.
Lorsque la courbe F1 présente un plateau plutôt qu'un pic unique, le choix du seuil de confiance idéal dépend de vos objectifs spécifiques :
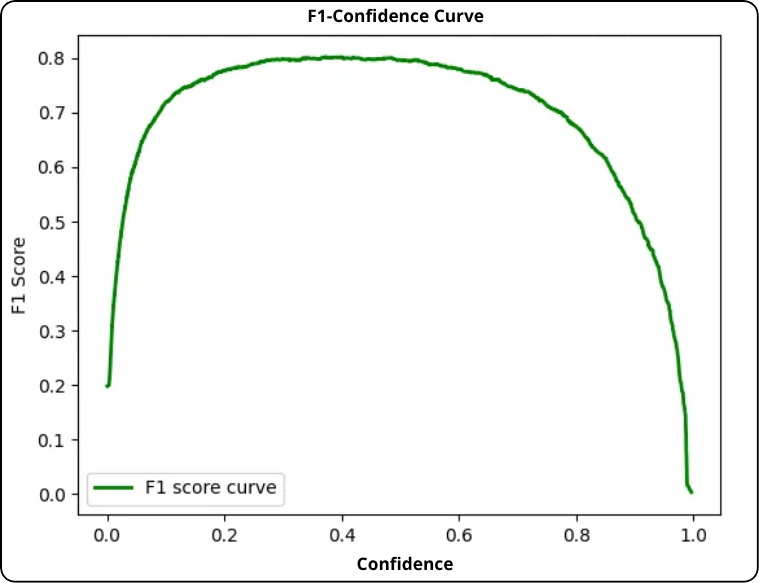
- Priorité à la précision (éviter les faux positifs) : choisissez la valeur à l'extrémité droite du plateau (seuil plus élevé). Cela garantit que le modèle ne prédit que lorsqu'il est très sûr, minimisant les erreurs de détection.
- Priorité au rappel (éviter les faux négatifs) : choisissez la valeur à l'extrémité gauche du plateau (seuil plus bas). Cela permet de capturer un maximum d'objets réels, quitte à accepter quelques fausses alertes.
- Équilibre : Si aucune contrainte ne prévaut, le centre du plateau est souvent un choix robuste.
-
-
-
Dans un contexte multi-classes, la matrice de confusion s'étend pour inclure une ligne et une colonne par catégorie, plus une dimension « background » (négatif) représentant l'absence d'objet. Les lignes indiquent les prédictions et les colonnes la vérité terrain.
La diagonale principale conserve sa signification de prédictions correctes. Les erreurs de classification occupent désormais l'ensemble des cellules hors diagonale. La colonne "background" recense les fausses détections (objets prédits mais absents), tandis que la ligne "background" identifie les objets réels non détectés.
Pour calculer les métriques de performance (précision, rappel, score F1) et déterminer le seuil de confiance optimal, il est nécessaire de décomposer cette matrice globale. L'analyse s'effectue selon une approche « un-contre-tous » : une matrice binaire 2x2 est générée pour chaque classe individuellement, isolant les vrais positifs, faux positifs, vrais négatifs et faux négatifs spécifiques à cette catégorie.
Déjà, nous n’avons pas besoin des vrais négatifs comme vu tout à l'heure.
Voyons comment trouver les trois restantes en prenant encore une fois la classe “Penny” comme exemple.
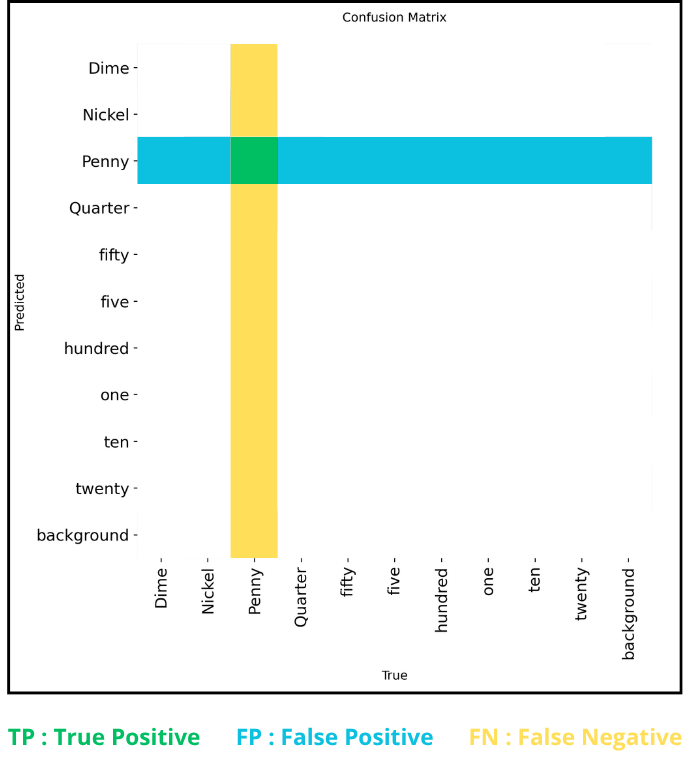
Pour une classe donnée (ex. : « penny »), les métriques se définissent ainsi à partir de la matrice :
- Vrais Positifs (TP) : Unique cellule à l'intersection de la ligne et de la colonne de la classe (diagonale).
- Faux Positifs (FP) : Somme de toutes les autres cellules de la ligne de la classe (prédites comme la classe mais appartenant à une autre).
- Faux Négatifs (FN) : Somme de toutes les autres cellules de la colonne de la classe (appartenant à la classe mais prédites comme une autre).
Ces valeurs permettent de calculer la précision et le rappel pour un seuil de confiance spécifique, chaque matrice de confusion correspondant à un seuil unique ; la répétition de ce calcul sur l'ensemble des seuils possibles génère ainsi les courbes de performance. Ce processus itératif est répété pour chaque classe, produisant autant de courbes individuelles. Une courbe de synthèse, dite « moyenne » (représentée en gras sur les graphiques), est ensuite dérivée de l'agrégation de l'ensemble des courbes par classe, offrant une vue globale de la performance du modèle.
À titre indicatif, la valeur optimale du seuil de confiance, correspondant à l'abscisse du maximum de la courbe F1, est directement indiquée dans la légende, immédiatement après la mention « all classes ».
MATRICE DE CONFUSION MULTI-CLASSE NORMALISÉE
Enfin, il reste la matrice de confusion normalisée. Elle permet d’avoir une vision globale car au lieu de donner les chiffres, elle donne des pourcentages.
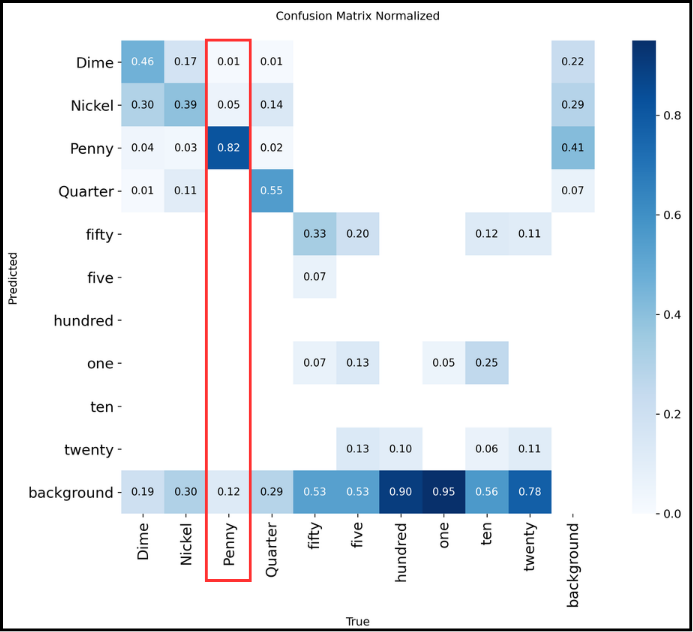
Comment la lire ?
La matrice de confusion normalisée permet de voir les pourcentages de détection pour chaque classe donc elle se lit colonne par colonne. Par exemple, pour les “Penny” de haut en bas :
- 1% ont été pris pour des “Dime”
- 5% ont été confondu avec des “Nickel”
- 82% des “Penny” ont bien été reconnu
- 12% n’ont pas du tout été détecté
On a bien 100% en faisant la somme donc c’est bon.
-
-
-
labels.jpg est une image avec quatre graphiques similaires à l’image ci-dessous :
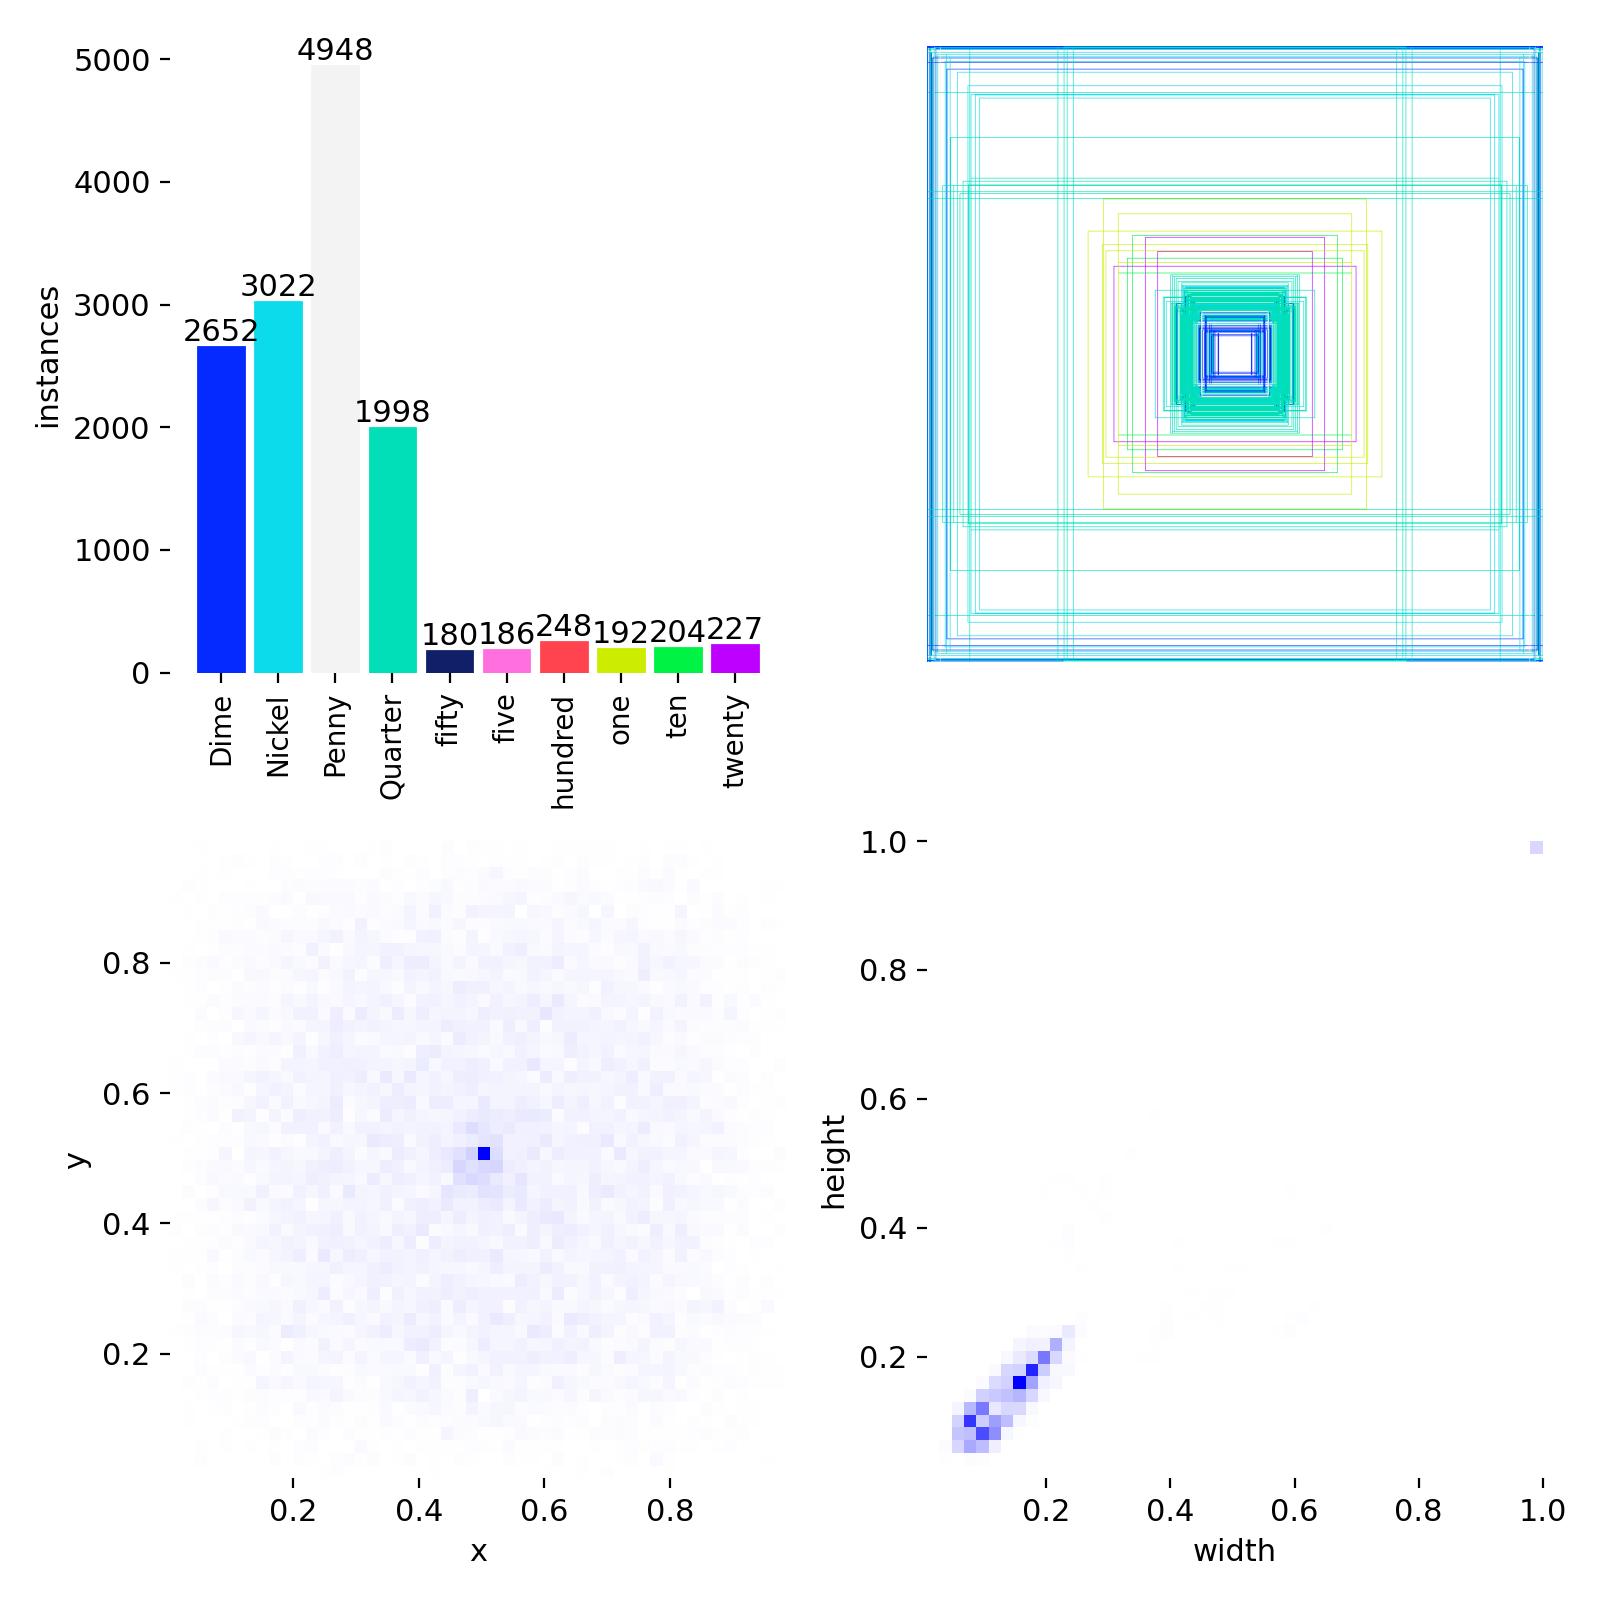
En haut à gauche : la répartition des différentes classes.
En haut à droite : superposition de toutes boites englobantes.
En bas à gauche : les coordonnées du centre des boites englobantes.
En bas à droite : les dimensions des boites englobantes.
Ce sont des statistiques sur les données annotées, ce fichier est indépendant de l’entrainement.
-
-
-
Ces documents contiennent les mêmes métriques, l’un sous forme de tableau csv, l’autre sous forme de graphiques.
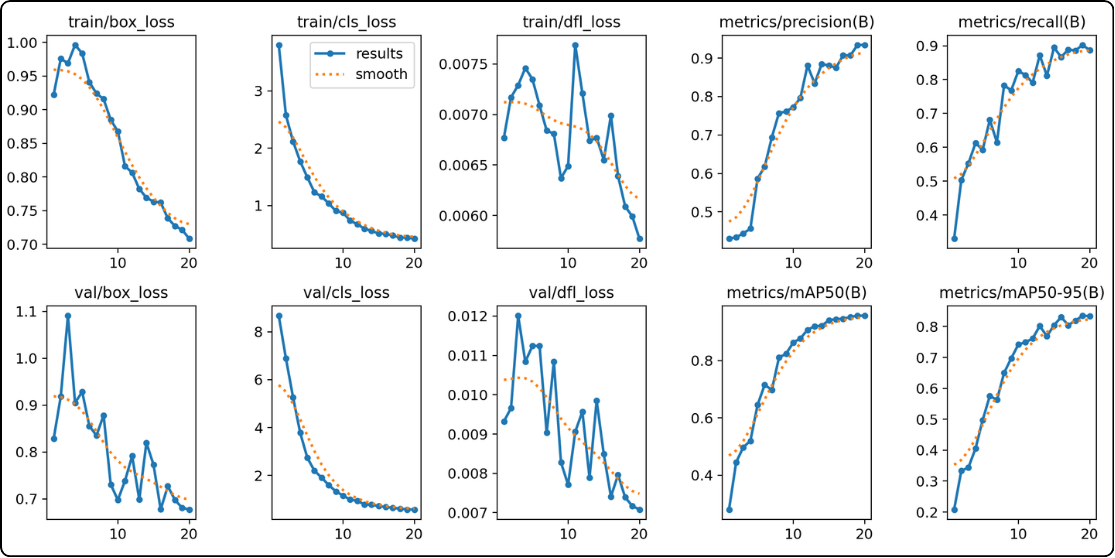
Les graphiques de résultats se divisent en deux groupes permettant d'évaluer la convergence et l'efficacité du modèle :
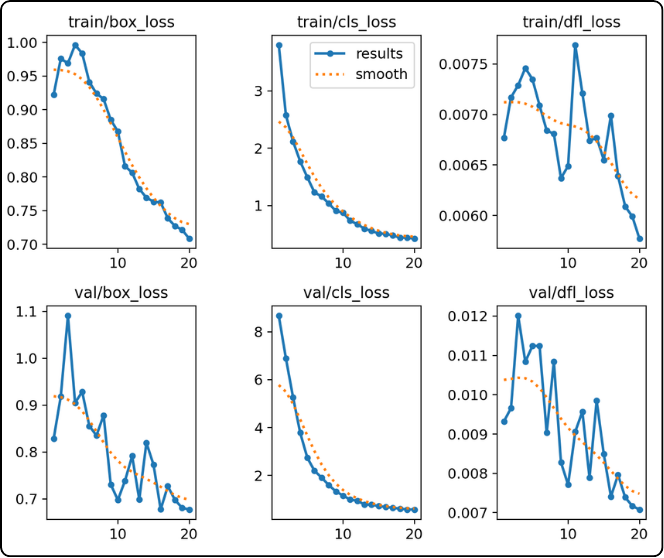
- les six courbes de gauche (les loss) : le modèle apprend et fait moins d’erreurs
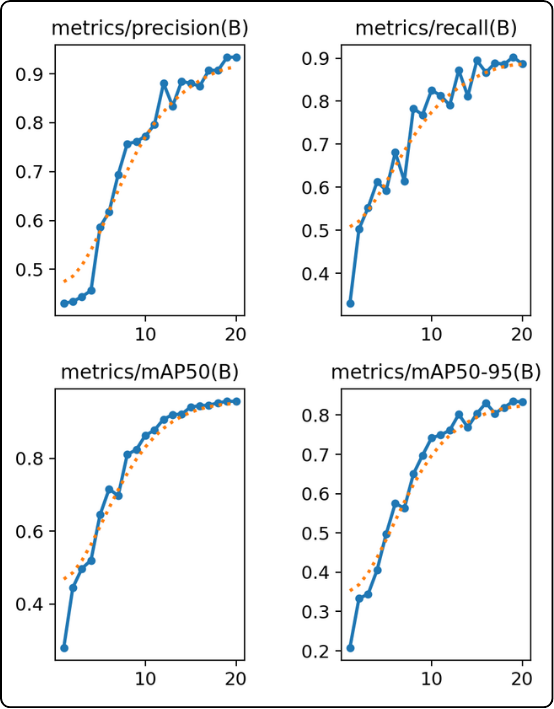
Les courbes de métriques (deux colonnes de droite) : Précision, Rappel, mAP50 et mAP50-95 illustrent la montée en compétence du modèle. L'objectif est d'observer la progression de ces courbes jusqu'à l'atteinte d'un plateau. Une stabilisation indique que le modèle a atteint son potentiel maximal et que l'entraînement peut cesser. À l'inverse, une croissance continue suggère qu'un prolongement de l'entraînement est nécessaire.
- les quatre courbes de droite (precision, recall, mAP50, mAP50-95) : le modèle devient plus performant
Les courbes de perte (trois colonnes de gauche) : Elles montrent l'évolution de l'erreur (loss) durant l'entraînement et la validation. Une décroissance simultanée de ces deux courbes est le signe idéal d'un modèle qui apprend correctement et généralise bien ses acquis.
POUR ALLER PLUS LOIN
Le surapprentissage survient lorsque le modèle mémorise par cœur les données d'entraînement au lieu d'apprendre des motifs généralisables. Il devient alors incapable de performer sur de nouvelles données.
- Détection visuelle : Ce phénomène se repère par une divergence des courbes de perte. Si la courbe d'entraînement (haut) continue de descendre alors que celle de validation (bas) remonte, le modèle surapprend. La courbe de validation agit comme un témoin neutre, car le modèle ne s'entraîne pas sur ces données.
- Gestion automatique et ressources : YOLO atténue ce risque en sauvegardant deux versions :
last.pt(état final, potentiellement surappris) etbest.pt(meilleurs poids enregistrés avant la dégradation de la validation). Bien quebest.ptgarantisse la performance, le surapprentissage reste une consommation inutile de temps et d'énergie de calcul. - Optimisation via le paramètre
patience: Pour éviter ce gaspillage, il est recommandé d'utiliser le paramètrepatience. Celui-ci arrête automatiquement l'entraînement si aucune amélioration n'est détectée sur la validation après un nombre défini d'époques, assurant ainsi que le processus s'interrompt dès que le modèle atteint son optimum.
-
-
-
Si les fichiers de résultats de votre modèle sont satisfaisant, vous pourrez ensuite tester votre modèle sur d’autres données, notamment votre dossier “test”.
Mais comment savoir si son modèle est bien ? Ouvrez votre dossier de résultats et repassons sur les points importants à aller vérifier.
SYNTHÈSE DES MÉTRIQUES DE PERFORMANCE
- Score mAp50-95 :
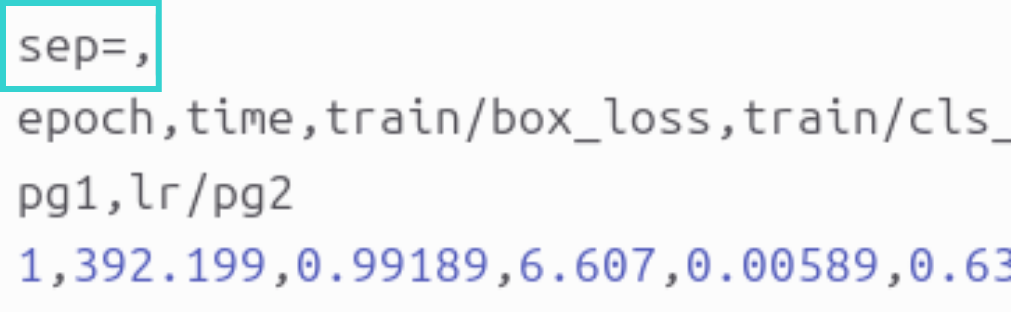
- où le trouver : dans le fichier results.csv. Point important : dans ce fichier, le séparateur est une virgule "," alors que si vous utilisez Excel, il s'attend à des point-virgule donc le fichier sera illisible. Pour pallier ce problème, ouvrez d'abord votre fichier dans un éditeur de texte, et rajoutez une première ligne où vous écrirez "sep=," comme dans l'image ci dessous :
-
- enregistrez la modification, fermez le fichier puis vous pouvez l'ouvrir dans Excel.
- chaque ligne correspond à une époque et chaque colonne contient les valeurs des différentes mesures de pertes, de métriques et du taux d'apprentissage pour l'époque donnée. La colonne qui nous intéresse est celle appelée : metrics/mAP50-95(B).
- descendez tout en bas de votre document pour pouvoir avoir la valeur de cette métrique lors de la dernière époque de votre modèle.
- quelle valeur est une bonne valeur :
- inférieur à 0.3 : mauvais
- supérieur à 0.5 : pour des objets complexes : bien
- supérieur à 0.7 : excellent
- Courbes de pertes :
- où les trouver : dans le fichiers results.png pour pouvoir visualiser directement les courbes pour voir leur tendance.
- ce qu'il faut observer :
- si les deux courbes descendent et se stabilisent, votre modèle est bien
- si les courbes de validation (val) remontent alors que celles de l'entrainement (train) descendent, votre modèle est mauvais (signe de surapprentissage)
- Score F1 :
- où la trouver : c'est le fichier BoxF1_curve.png
- ce qu'il faut vérifier :
- il faut que le courbe monte haut, le plus proche de 1.0.
- ce qu'il faut récupérer :
- récupérez l'abscisse du maximum car c'est la valeur optimale à donner à votre seuil de confiance. C'est la valeur qui est écrite dans la légende à côté de "all classes". On y lit : "all classes valeur_max at seuil_optimal" donc vous récupérez la deuxième valeur pour la mettre dans la variable "conf" au moment du déploiement de votre modèle.
- Retour visuel (valbatchXpred.jpg) :
- ces images correspondent à la sortie du modèle, donc cela vous permet d'avoir un retour visuel de votre entrainement. Vous pouvez y vérifier que la détection se passe bien, que les boites sont au bon endroit et qu'aucun objet n'est oublié.
VALIDATION SUR LE JEU DE TEST
Si le modèle semble satisfaisant, évaluez le sur des données inédites (dossier « test ») :
Chargement : Importez le modèle optimisé (best.pt) situé dans runs/detect/trainX/weights :
from
          ultralytics
          import
          YOLO
model = YOLO(“chemin/vers/votre/fichier/best.pt”) # n’hésitez pas à mettre le chemin absolu sauf si vous êtes sur le clusterConfiguration : Assurez-vous que le fichier data.yaml contient le chemin vers le jeu de test (ou créez un data_test.yaml).
Exécution : Lancez la validation spécifique :
metrics
            =
            model.val(split=”test”)
Analyse : Consultez les résultats générés dans runs/detect/valX. Si les performances sont insuffisantes, un réentraînement est nécessaire.
RÉENTRAINEMENT ET OPTIMISATION
Pour améliorer un modèle sous-performant, deux stratégies sont possibles :
- Prolongation de l'entraînement :
- Chargez impérativement les poids de la dernière époque (
last.pt) et non les meilleurs (best.pt). - Lancez l'entraînement avec l'option
resume=True. Le paramètreepochsindique alors le nombre total d'époques visé (ex. : pour passer de 100 à 150 époques, indiquezepochs=150).
- Chargez impérativement les poids de la dernière époque (
from
          ultralytics
          import
          YOLO
model = YOLO(“chemin/vers/votre/fichier/last.pt”)results = model.train(epochs=150, resume=True)- Ajustement des hyperparamètres : Si la prolongation de l'entraînement s'avère insuffisante, il pourra être nécessaire de modifier la configuration du modèle (taux d'apprentissage, taille du batch, architecture, etc.). Ces réglages avancés, spécifiques à chaque cas d'usage, ne sont pas détaillés dans ce document ; il est recommandé de consulter la documentation officielle d'Ultralytics ou les ressources spécialisées en ligne pour approfondir ces aspects.
- Score mAp50-95 :
-
-